计算机组成与体系结构
CPU 组成
运算器:
- 算术逻辑单元 ALU:数据的算术运算和逻辑运算
- 累加寄存器 AC:通用寄存器,为 ALU 提供一个工作区,用在暂存数据
- 数据缓冲寄存器 DR:写内存时,暂存指令或数据
- 状态条件寄存器 PSW:存状态标志与控制标志
控制器:
- 程序计数器 PC:存储下一条要执行指令的地址
- 指令寄存器 IR:存储即将执行的指令
- 指令译码器 ID:对指令中的操作码字段进行分析解释
- 时序部件:提供时序控制信号
- 现代 CPU 将控制单元(控制器)和运算单元(运算器)集成为一体。
- ARM CPU 是通用处理器,GPU、DSP、FPGA 均为专用处理器。
- DSP 采用哈佛架构,CPU 采用冯诺依曼架构
存储系统
- 存储单元个数 = 最大地址 - 最小地址 + 1
- 编址内容
- 按字编址;存储体的存储单元是字存储单元,即最小寻址单位是一个字
- 按字节编址:存储体的存储单元是字节存储单元,即最小寻址单位是一个字节
- 在由 Cache- 主存构成的层次式存储系统中,为了提高地址转换速度,主存单元到 Cache 单元的地址转换采用硬件完成。
- Cache 平均访问时间计算公式:
已知 Cache 的访问命中率为 0.8,Cache 存取时间为 20ns,主存访问时间为 100ns,则系统的平均访问时间为 0.8 * 20ns + 0.2 * 100ns = 16ns + 20ns = 36ns
磁盘管理
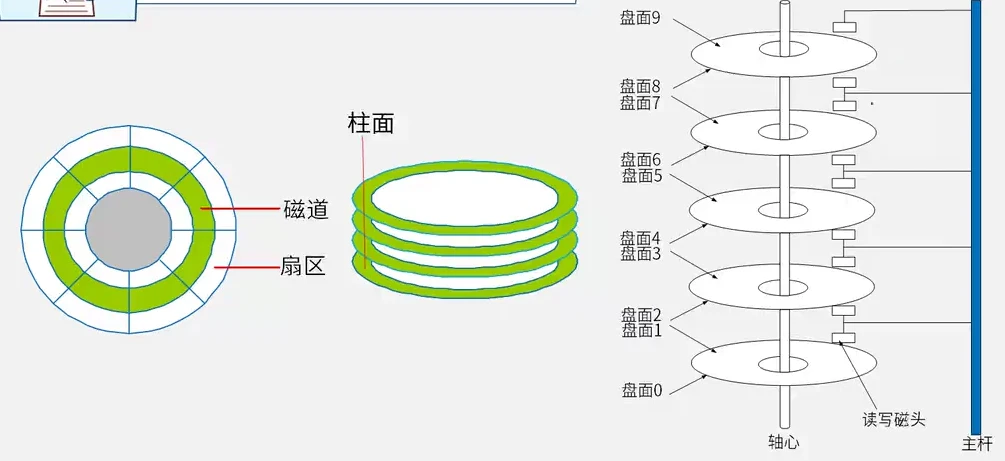
读取磁盘数据的时间应包括以下三个部分:
- 找磁道的时间。
- 找块央(扇区)的时间,即旋转延迟时间。
- 数据传输时间。
平均存取时间 = 寻道时间 + 等待时间(题目未说明则不考虑数据读写时间)
当文件处于 ” 未打开 ” 状态时,文件需占用三种资源:一个目录项;一个磁盘索引节点项;若干个盘块。 当文件被引用或 ” 打开 ” 时,须再增加三种资源:一个内存索引节点项,它驻留在内存中;文件表中的一个登记项;用户文件描述符表中的一个登记项。
磁盘读取时间
某软盘有 40 个磁道,磁头从一个磁道移至另一个磁道需要 5ms。文件在磁盘上非连续存放,逻辑上相邻数据块的平均距离为 10 个磁道,每块的旋转延迟时间及传输时间分别为 80ms 和 20ms,则读取一个 100 块的文件需要(15000)ms。
5 x 10 + 80 + 20 = 150, 150 x 100 = 15000
处理时间(单缓冲区)
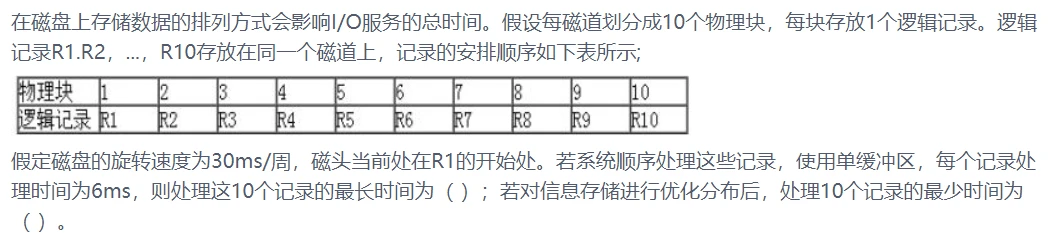
- 一圈 30ms,一圈有 10 块,=> 读一块要 3ms
- 读出来的一块放入单缓冲区,处理要 6ms
- 读完并处理完第一块,一共 9ms,此时磁头已经过了 R2,到了 R4 的开始处,因此想读 R2 就得绕 8 块,
8*3=24ms到达 R2 的开头,然后读 + 处理 R2,一共24+9=33ms - R2 到 R10 都是如此,因此一共
9*33=297ms - 加上第一块的 9ms,一共
297+9=306ms(最长时间)
重新排布,让 R1 读完处理完后,磁头到达的地方改成 R2,以此类推,则最短时间= (3+6)*10=90ms)
处理时间(双缓冲区)
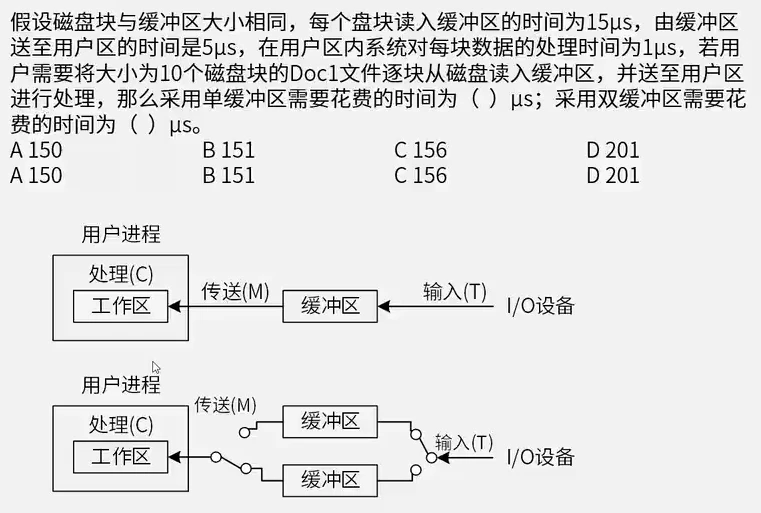
对于单缓冲区:
- 读取 15,送入 5,一共 20 us
- 用户区处理,需要 1 us
- 对于下一个磁盘块,前面的 20 us 需要等待,但是送入用户区后,就可以并行处理了(即上一个块处理的 1 us,下一个块就可以往缓冲区里读了)。因此对于总时间,上一个磁盘块的 1 us 处理时间无需计算
- 接下来的磁盘块同第 3 步,直到最后一个盘块,因为后面没有任务了,所以需要计算 1us 的处理时间
- 总时间 =
对于双缓冲区:
双缓冲区可以一个读一个写,但不能两个同时读或者同时写
- 读取 15
- 送入 5,处理 1,一共 6 us
- 对于下一个数据块,由于存在两个缓冲区,因此第一个块读取完后(15 us) ,开始送入用户区并处理时(5+1=6 us),第二个块就可以开始读入缓冲区了。因此对于总时间,上一个磁盘块的 6 us 无需计算
- 接下来的盘块同第 3 步,直到最后一个块,需要计算 5+1=6 us
- 总时间 =
调度算法
移臂调度:
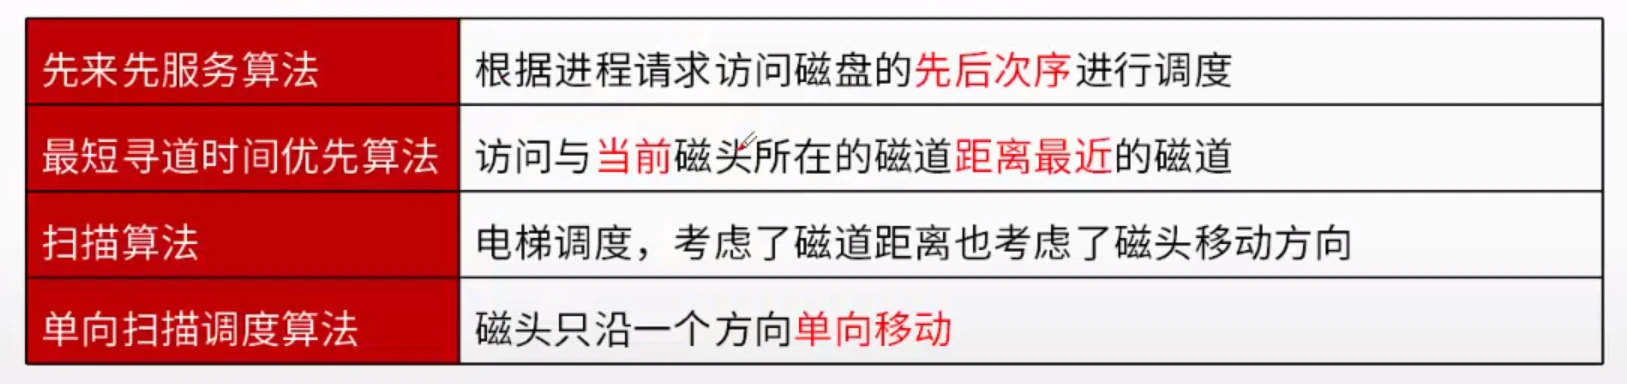
单向扫描也叫循环扫描(CSCAN)
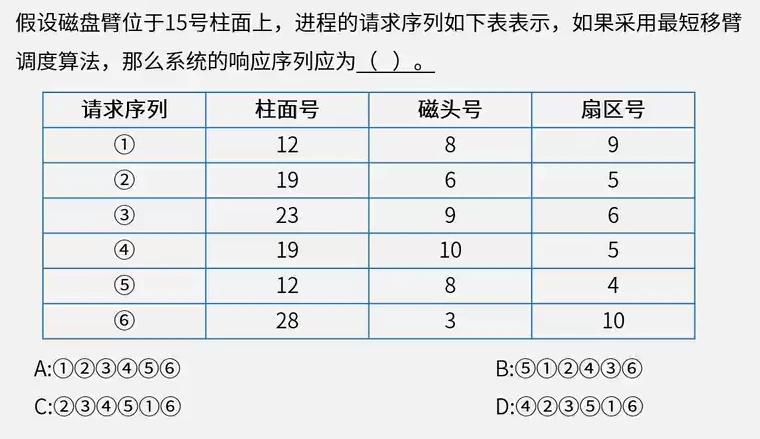
-
首先统计每个柱面的请求:
12: 1, 519: 2, 423: 328: 6 -
按最短移臂调度算法,距离当前 15 柱面最近的是 12,因此请求序列:1,5 或者 5,1
-
距离 12 最近的是 19,请求序列:5,1,2,4
-
以此类推,最终序列为 5,1,2,4,3,6
数据传输控制方式
- 程序控制(查询)方式:分为无条件传送和程序查询方式两种。方法简单,硬件开销小,但 IO 能力不高,严重影响 CPU 利用率。
中断
- 中断方式下,IO 系统与外设交换数据时,CPU 可以并行处理其他任务。
- 管理键鼠最适合的 IO 方式是中断,不是 DMA
- 中断流程
- IO 准备好后,发出中断请求
- CPU 收到信号后,保存现场(断点信息保存在栈中),转入执行 IO,完成后返回被打断的程序继续执行
保存现场、中断处理、恢复现场
- 中断向量:系统中有多个中断源,用中断向量表保存各个中断服务程序的入口地址
- 嵌入式系统中采用中断方式实现输入输出的主要原因是能对突发事件做出快速响应。
- 四种中断类型:
- 信号中断通常是由外部设备或定时器发出的。
- 溢出中断发生在程序执行过程中产生算术溢出时。
- 访管中断是应用程序使用特权指令触发的,目的是请求操作系统提供服务(即系统调用)。
- 外部中断由硬件设备(如键盘、鼠标、定时器等)触发。
- 缺页中断:缺页中断发生在所需页面不在物理内存(但存在于磁盘交换区)时,操作系统需将其调入内存。若页面不存在,则引发访问错误。
DMA
- Direct Memory Access,直接内存存取方式:数据在主存(内存)和 IO 设备(外设)间直接传送,不需要 CPU 干预
- 硬件电路实现
- 硬盘使用 DMA
- 一个 DMA 传送只需要执行一个 DMA 周期,即一个总线读写周期
同类说法: CPU 是在一个总线周期结束时响应 DMA 请求的
- DMA 传送结束事件会触发 CPU 请求,是中断
异同点:1. 都可实现外设与 CPU 之间的并行工作;2. 中断需要 CPU 介入传输,DMA 不需要;3. DMA 速度更快
总线
总线是一组能为多个部件分时共享的公共信息传送线路。
-
分时:是指同一时刻仅允许一个部件向总线发送信息。
-
共享:允许多个部件同时从总线上接收相同的信息。
-
内总线、片上总线、片内总线是同一个概念
-
外部总线是计算机板和外部设备之间,或者计算机系统之间互联的总线,又称为通信总线。
- 并行总线适合近距离高速数据传输
- 串行总线
- 适合长距离数据传输
- 传输的波特率在使用中可以改变
- 数据发送和接收可以使用多种方式,程序查询方式和中断方式都可以
- 专用总线在设计上可以与连接设备实现最佳匹配
- 单总线结构的优点是控制简单方便,扩充方便,性能不高
- 单工、半双工与全双工总线
- 单工:A 只能发信号,B 只能收信号(广播)
- 半双工:AB 都可发可收,但同一时间只能一个发一个收(对讲机)
- 全双工:AB 都可发可收,而且可以同时进行(电话)
- 总线宽度与总线带宽(B/s)。数据总线宽度越大,单位时间内能进出 CPU 的数据就越多,系统的运算速度越快。
指令系统
RISC(精简):Reduced
- 指令数量少、使用频率接近、定长格式
- 支持寻址方式少
- 硬布线,硬件
- 优化编译
- 采用流水线
- 采用很多寄存器
- Arm
CISC(复杂):Complex
- 指令数量多、使用频率差别大、可变长格式
- 多种寻址方式
- 微程序控制技术(微码)
- 研制周期长
- 不采用流水线
- 采用很少寄存器
- x86(Intel, AMD)
流水线
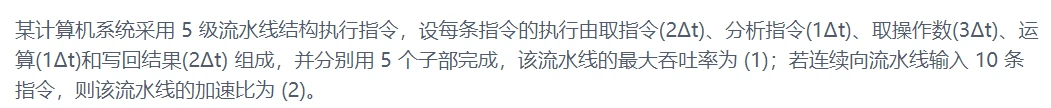
- 执行周期/流水线周期: (最长的那个时间)
- 首条指令执行时间:
- 流水线执行时间(理论公式):首条指令执行时间 + (指令数 -1) x 执行周期 = ,当 时,执行时间 =
- 最大吞吐率(流水线周期的倒数): (指令条数 / 流水线执行时间 )
- 加速比:不采用流水线的时间 / 采用流水线的时间
- 不采用:
- 采用:
- 加速比 =
流水线执行时间的实践公式:,即每一步骤的执行时间都按照流水线周期(最大时间)计算
(普通)流水线吞吐率=指令数/执行时间
等效指令时间= Σ(指令占比 × 指令时间)
校验码
奇偶校验码:
- 在有效信息上加冗余二进制位
- 奇校验:整个校验码(数据位 + 校验位)中 1 的个数为奇数
- 偶校验:整个校验码中 1 的个数为偶数
- 只能检测代码中奇数个位出错的编码,但不能发现偶数个位出错的情况,不可纠错。
- 校验码一般拼接在头部
海明码:
-
海明码利用奇偶性进行检错和纠错
-
码距最小为 2n+1
-
校验码存放在 的位置
-
数据位 n,校验位 k,则
例:对于 32 位的数据,至少需要加(6)个校验位才能构成海明码。
循环冗余校验码(CRC):
- 采用模 2 运算来构建校验位的,是 CRC 循环冗余校验码
- 可检错,不可纠错
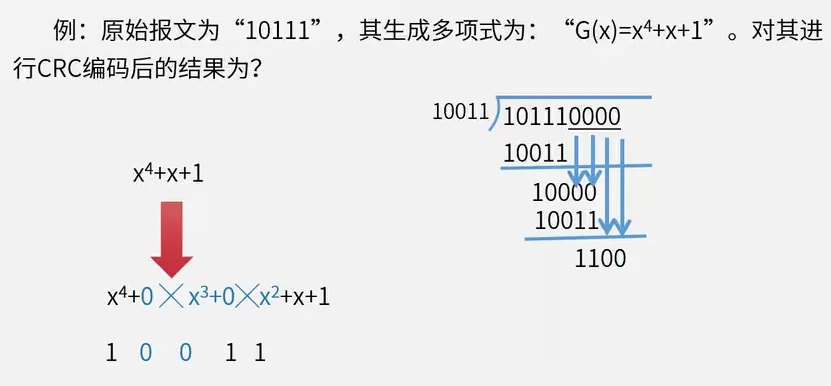
- 根据生成多项式求解出系数:
10011,即 的系数拆出来 - 系数有 5 位,得到余数位是 4(5-1)
- 将原始报文补充余数位个数的 0 (4 个 0)得到被除数:
10111 + 0000 = 101110000 - 利用被除数和系数进行模 2 运算得到余数
1100 - 将余数添加到原始报文末尾得到 CRC 编码结果
10111 + 1100 = 101111100
操作系统
多道批处理
- 多道批处理具有宏观并行性,在微观上仍是串行执行
- 允许一次多个作业装入内存执行(同一时刻只能有一个作业装入内存是单道批处理)
实时操作系统
- 实时操作系统(RTOS)内核与应用程序之间的接口称为 API
- 大多数 RTOS 调度算法都是抢占方式(可剥夺方式,为了响应及时)
进程状态模型
-
进程的三部分:程序块、进程控制块(PCB)和数据块
-
进程的两个基本属性:可拥有资源的独立单位、可独立调度和分配资源的基本单位
- 线程只是可以独立调度,但不作为分配资源的单位
- 线程的程序计数器、寄存器和栈都是独立的
- 线程的内存地址空间、代码、数据、文件等是共享的
-
进程的三态/五态图:
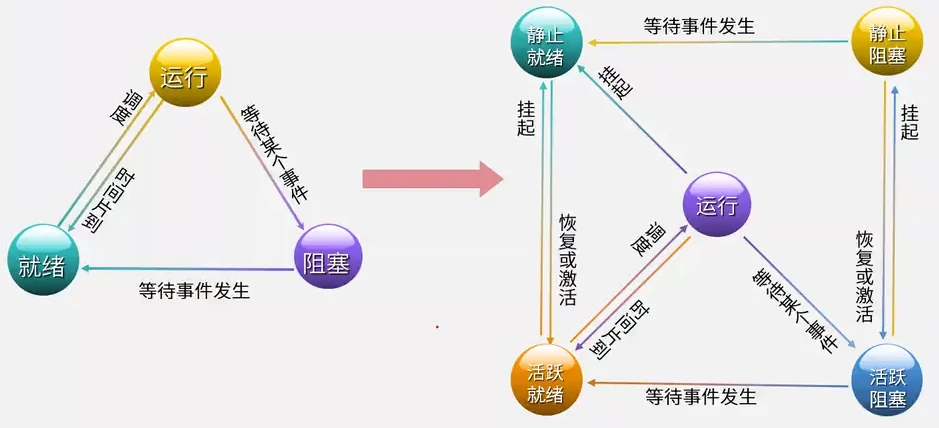
- 活跃指的是在内存中,静止指的是被交换到硬盘中
- 五态图相比于三态图,主要就是由于挂起导致多出的两个状态:就绪挂起(静止就绪)和阻塞挂起(静止阻塞)。
- 原始的三个状态均可以被挂起成为新的状态。但静止就绪和静止阻塞均可以被激活从而回到内存,而静止阻塞变为静止就绪仍需等待事件发生,且仍然位于硬盘中。
-
临界资源:进程间需要以互斥方式进行共享的资源,如打印机等
-
临界区:每个进程中访问临界资源的那段代码称为临界区。V 操作是在离开临界区后执行,用于释放资源。
-
一个进程被唤醒意味着进程变为就绪状态
前趋图
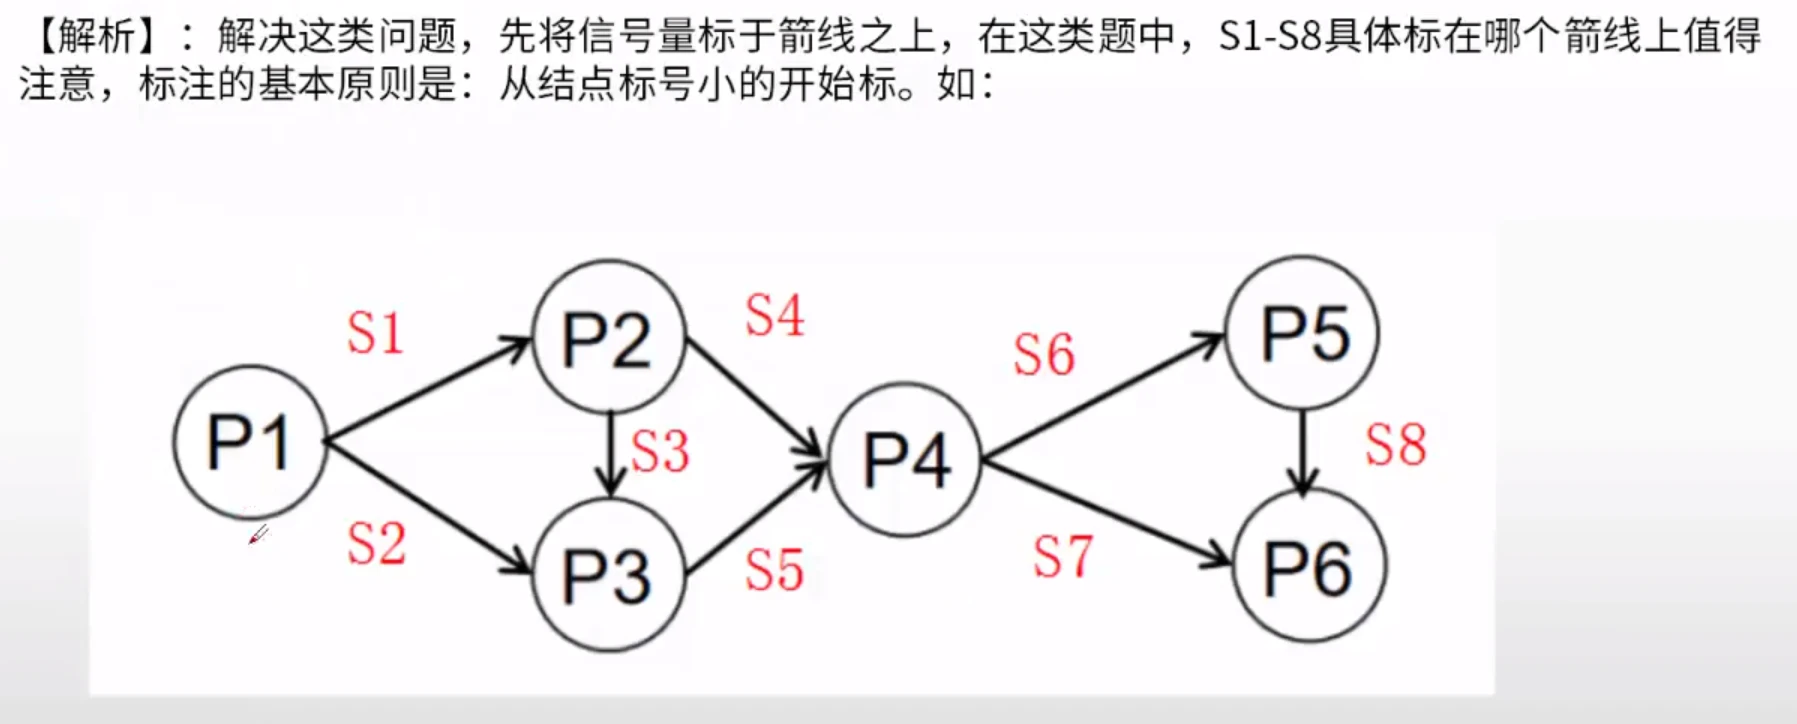
从标号小的开始,然后一个点出发的按照终点标号小的开始,全部标完后,再开始第二个点。
注意⚠️,这里哪怕是 P3 指向 P2,也是先标 P3-P2,而不是 P2-P4。
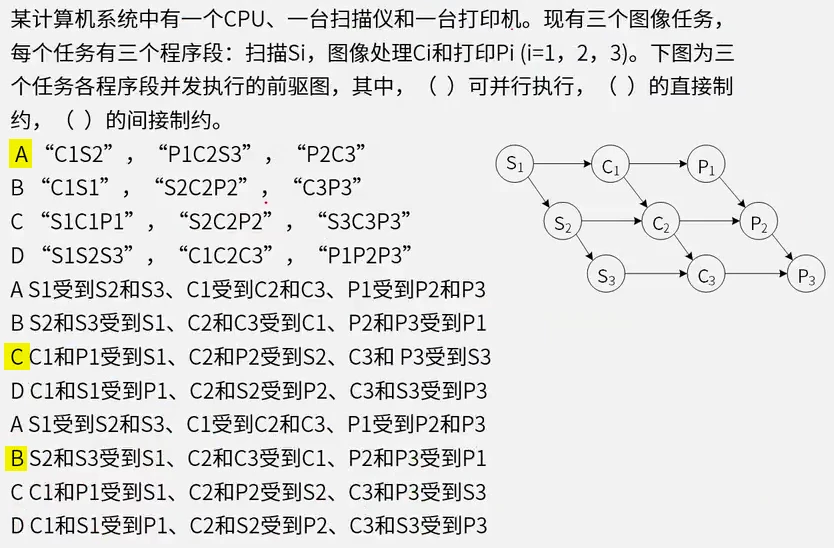
- 直接制约:不同类型进程之间存在先后顺序,例如 S1 执行完才可以执行 C1,因此 C1 受到 S1 的直接制约
- 间接制约:同一类型进程受到资源限制,例如 S2 要等 S1 用完扫描仪才能执行,因此 S2 受到 S1 的间接制约
- 图中有几个线段就需要多少信号量
存储管理
计算芯片数
内存按字节编址,利用 的存储器芯片构成 84000H 到 8FFFFH 的内存,需要()片?
- 8FFFFH-84000H+1=C000H(地址数)
- 按字节编址 => 每个地址是 8bit
- 内存大小=C000H * 8bit =
- ,即 12 片
页式存储
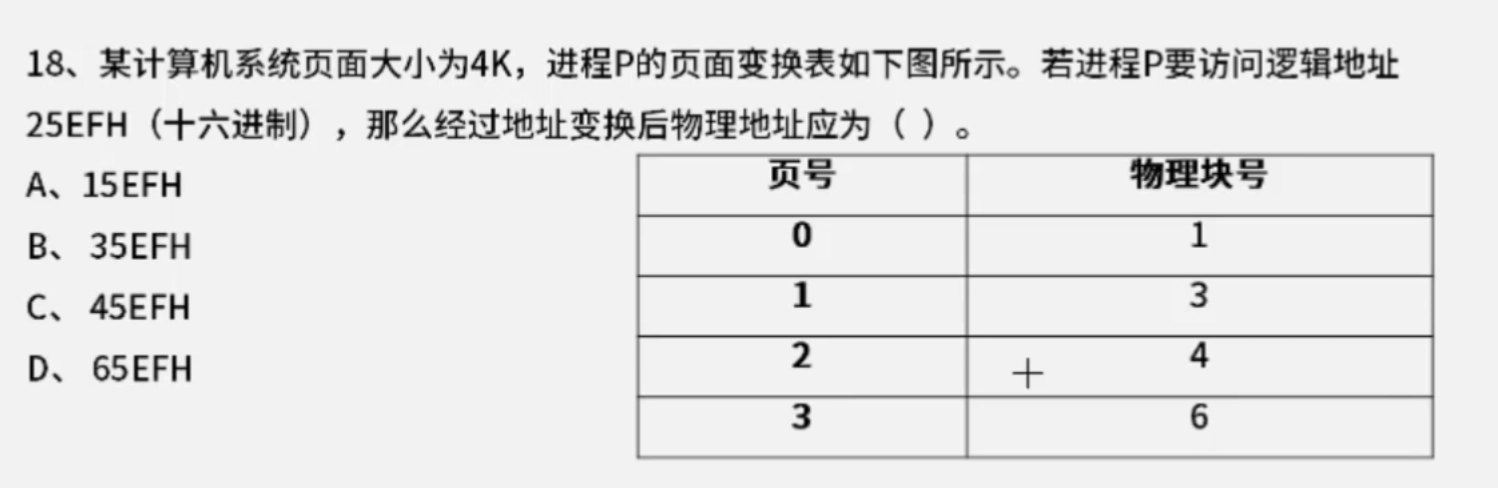
页面大小 ,所以逻辑地址为 12 位。一个 16 进制位是 4 个 2 进制位,所以逻辑地址 25EFH (H 是 16 进制的标志) 的后三位 5EF (3x4=12) 为页内地址,即 2 是页号。
从表里查,页号 2 对应的块号是 4 ,所以物理地址 45EF = 4 + 5EF
段式存储
段式存储(Segmentation)是一种内存管理方式,将程序分为若干个逻辑段,每个段表示程序的一个逻辑单元(如代码段、数据段、堆栈段等)。
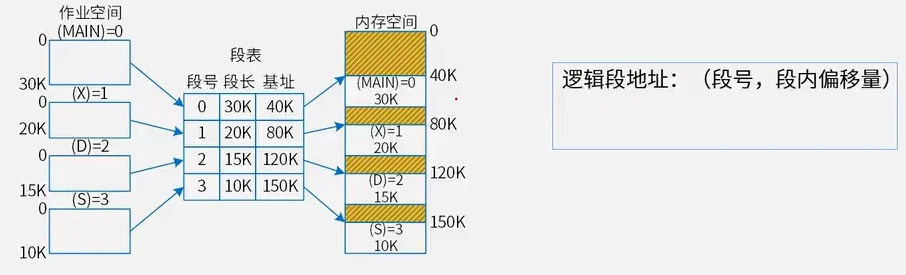
- 段长:段落的物理地址长度
- 基址:段落的起始地址
- 如何判断段地址是否非法:段地址的段内偏移量应该小于段长
- 例如
(0, 35k),其段内偏移量为35k,但根据段表可查 0 号段的段长为30k,因此这是一个非法段地址 - 非法的原因是逻辑地址到物理地址转换时地址越界
- 例如
- 段的长度取决于其存储的数据量,可以在程序运行时根据需要动态调整。
段页式存储
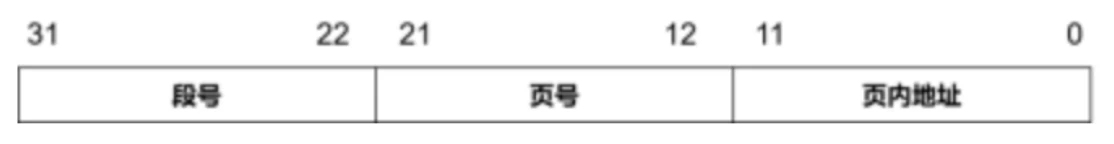
31-22+1=10,21-12+1=10,
最多可有 1024 个段,每个段最大允许有 1024 个页,页的大小为 4K
文件管理
逻辑结构
- 记录式文件:一条条记录,关系型表格。
- 流式文件:连续的字节流,例如普通文本文件、图片等。
多级索引
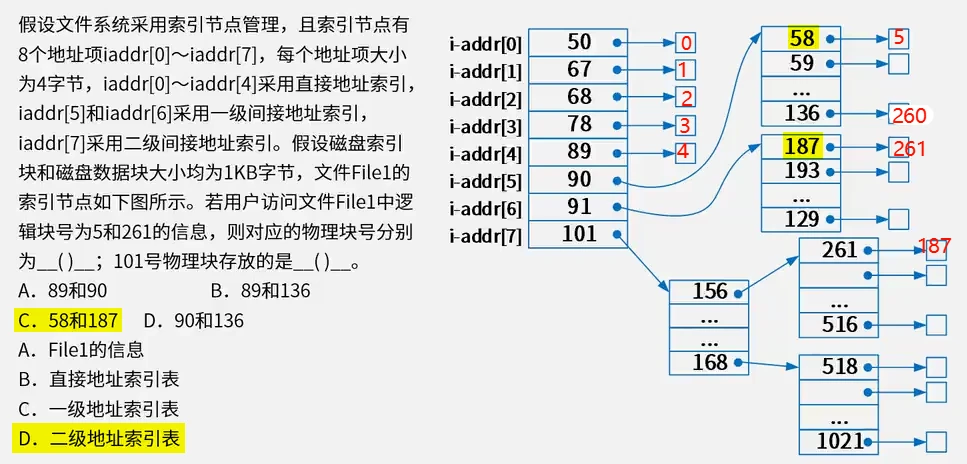
- 前五个是直接地址索引,因此对应逻辑地址 0-4,那么下一个 5 号逻辑块对应的物理块就是 90 指向的第一个 58
- 从 58 号物理块(即 5 号逻辑块)开始,采用一级间接地址索引
- 地址大小为 4B,索引块大小为 1KB,则一个索引表有 个地址
- 因此,从 5 号逻辑块到 号物理块共有 256 个值,求解 得 ,即 90 号物理块指向的逻辑块范围为 5-260
- 由图可知,260 号逻辑块的下一块就是 261 号逻辑块,对应物理块号为 187
- 某文件系统采用多级索引结构,若磁盘块的大小为 512 字节,每个块号需占 3 字节,那么根索引采用一级索引时的文件最大长度为( )K 字节;采用二级索引时的文件最大长度为( )K 字节。
一个一级索引可存放的文件大小为:170×512=85 KB。
一个二级索引可存放文件的大小为:170×170×512=14450 KB。
一个三级索引可存放文件的大小为:170×170×170×512=2456500 KB。
位示图
- 字长:一个字包含多少个物理块,例如字长 32 位,表示一个字可记录 32 个物理块的使用情况。
- 某位取值为 0 表示空闲,1 表示占用。这也是位示图的作用,即管理磁盘空闲块
-
计算机系统字长为 64 位,磁盘容量 512GB,物理块大小为 4MB,则位示图大小为 (2048) 个字 512G/4MB = 个物理块 / 64 = 2048 个字
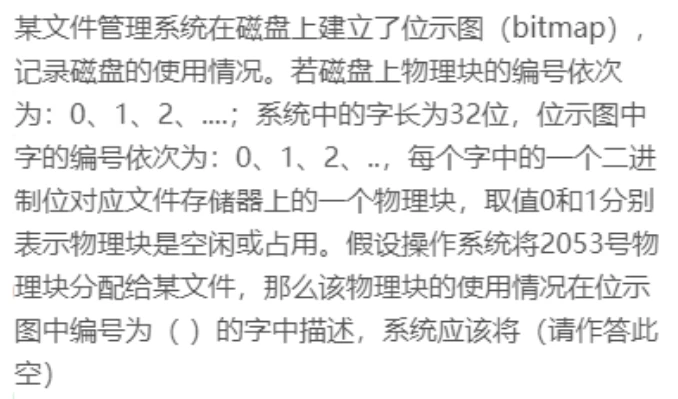
- 2053 号块 = 第 2054 个块,字长 32 位 = 一个字 32 个物理块- 2054/32 = 64 余 6,即占满了 0-63 号字,从 64 号字开始- 余下 6 个物理块,即 64 号字中的 0-5 号位,该块占用- 64 号字的位号 5 的位置”1“3. 操作系统采用页式存储管理,用位图管理空闲页框,若页大小为 4KB,物理内存大小为 16GB,则位图所占内存空间大小是(512)KB。 位图管理空闲页框时,每个页框对应 1 位(bit)。物理内存 16GB 即 2^34B,页大小 4KB 即 2^12B,总页框数为 2^34 / 2^12 = 2^22 个。位图总位数 2^22 位,转换为字节数为 2^22 / 8 = 2^19B。2^19B=512KB。
微内核
传统的宏内核 / 单体内核(Monolithic Kernel) 通常会把很多功能都放在内核态,微内核则相当于将网络服务、文件服务、驱动服务等放在用户态运行,因此,“微”指的是内核本身很小,而不是整个操作系统很小。
由于驱动等关建模可作为独立的用户态服务运行,因此不同模块之间的故障隔离更好,增强可靠性。也因为各个功能是相对独立的服务,很多情况下不需要修改整个内核,灵活性和可扩展性强。微内核的通信机制天然比较适合扩展到分布式系统。最大的代价通常是性能开销。
分级调度
- 高级调度(作业调度):高级调度主要存在于批处理系统中,用于将作业从外存调入内存。分时和实时操作系统通常不需要这种调度。
- 中级调度(内存调度):在多种操作系统中都可能存在,用于内存与外存之间的进程交换。
- 低级调度(进程调度):在所有多任务操作系统中都存在,用于分配处理器资源。
多机系统
多机系统按多机之间连接的紧密程度分为紧耦合多机系统和松耦合多机系统两种。
- 紧耦合多机系统又称直接耦合系统,指计算机间物理连接的频带较高,一般是通过总线或高速开关实现计算机间的互连,通过共享内存实现多机间的通信;
- 松耦合多机系统又称间接耦合系统,—般是通过通道或通信线路实现计算机间的互连。
- 对称多处理器结构(SMP(Symmetical Multi-Processing)技术,是指在一个计算机上汇集了一组处理器(多 CPU),各 CPU 之间共享内存子系统以及总线结构,所以属于紧耦合多机系统。
数据库
上古
- 早期数据库种类有 3 种:
- 层次式数据库:树状存储
- 网络式数据库:Graph,也叫导航式数据库
- 关系型数据库:略
连接
为空,即 为自然连接。这是一种特殊的等值连接,两个关系进行比较的分量必须是相同的属性组,并在结果中去除重复列
自然连接时被舍弃的元组称为悬浮元组
外连接:
- 如果把悬浮元组舍弃的也保存在结果关系中,空缺的部分填 NULL,则称为外连接
- 如果只保留左边关系 R 中的悬浮元组,则称为左外连接
- 反之,为右外连接
两阶段提交协议 2PC
- 2PC 事务提交的两个阶段
- 表决阶段,目的是形成一个共同的决定
- 执行阶段,目的是实现这个协调者的决定
- 两条全局提交规则
- 只要有一个参与者撤销事务,协调者就必须做出全局撤销决定
- 只有所有参与者都同意提交事务,协调者才能做出全局提交决定
数据库设计过程
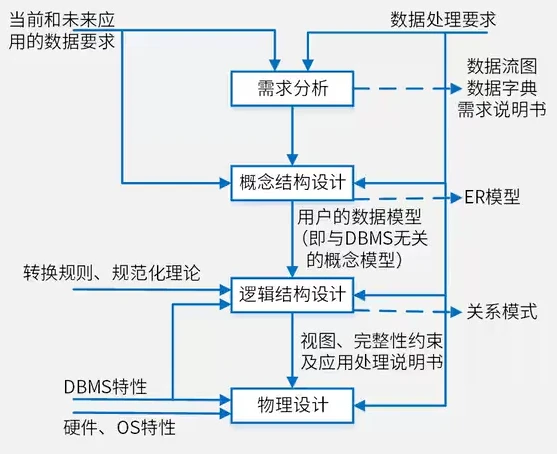
需求分析
对现实世界要处理的对象(组织、部门、企业等)进行详细调查,在了解现行系统的概况,确定新系统功能的过程中,确定系统边界、收集支持系统目标的基础数据及其处理方法。
概念结构设计
- 主要产物是实体关系模型(ER 模型,Entity-Relation)
- 不同实体有一对一(1:1),一对多(1
),多对多(m )联系 - ER 图集成的方法:
- 多个局部 E-R 图一次集成。
- 逐步集成,用累加的方式一次集成两个局部 E-R。
- 集成产生的冲突及解决办法:
- 属性冲突:包括属性域冲突和属性取值冲突。
- 命名冲突:包括同名异义和异名同义。
- 结构冲突:包括同一对象在不同应用中具有不同的抽象,以及同一实体在不同局部 ER 图中所包含的属性个数和属性排列次序不完全相同。
逻辑结构设计
| 联系类型 | 实体 (独立关系模式) | 联系 (独立关系模式) | 联系 (归并关系模式) | 备注 |
|---|---|---|---|---|
| 1 对 1 | ✅ | ✅ | ✅ | 并入任一端 |
| 1 对多 | ✅ | ✅ | ✅ | 并入多的一端 |
| 多对多 | ✅ | ✅ | ❌ |
- ✅表示可以转换为关系模式,❌表示不可以
- 一个实体型必须转换为一个关系模式
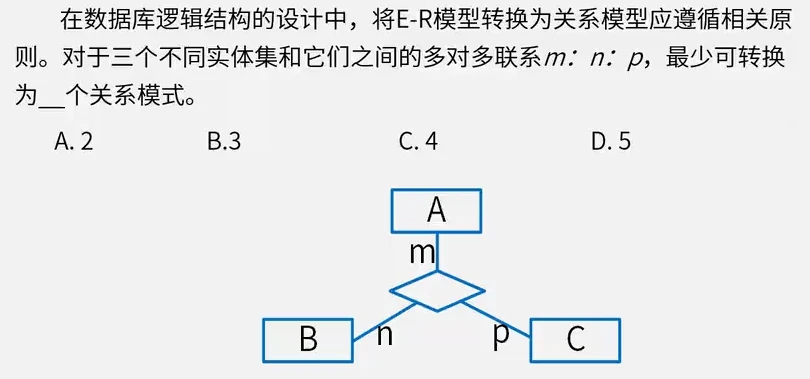
- 一个实体必须转一个,所以有 3 个关系模式
- 多对多联系无法归并,所以只能建立独立关系模式
A-B-C,这又是一个 - 所以最少可转换为 4 个关系模式
数据模型
- 数据模型三要素:数据结构、数据操作、数据的约束条件
- 层次模型、网状模型、面向对象模型、关系模型
- 目/度:关系模式中属性的个数
- 候选码(候选键):唯一标识元组,无冗余
- 主码(主键):任选一个候选键
- 主属性与非主属性:组成候选码的属性就是主属性,其他的为非主属性
- 外码(外键)
- 全码(ALL-Key):关系模式的所有属性组是这个关系的候选码
完整性约束
- 实体完整性约束:规定基本关系的主属性不能取空值。
- 参照完整性约束:关系与关系间的引用,其他关系的主键或空值。
- 用户自定义完整性约束:应用环境决定。
- 触发器
规范化理论
如何求候选键?
- 将关系模式的函数依赖关系用“有向图”的方式表示
- 找入度为 0 的属性,并以该属性集合为起点,尝试遍历有向图,若能正常遍历图中所有结点,则该属性集即为关系模式的候选键
- 若入度为 0 的属性集不能遍历图中所有结点,则需要尝试性的将一些中间结点(既有入度,也有出度的结点)并入入度为 0 的属性集中,直至该集合能遍历所有结点,集合为候选键
也可以通过函数依赖判断,只出现在左侧的即为候选键
Armstrong 公理
对关系模式 来说具有以下推理规则:
- 自反律(Reflexivity):若 ,则 成立
包含你就可以决定你
- 增广律(Augmentation):若 且 ,则 成立
决定你,两边同时加上也决定你
- 传递律(Transitivity):若 且 ,则 成立
根据上述三条推理规则可以得到另外三条推理规则:
- 合并规则:若 ,则 (依据 1,2)
- 伪传递规则:若 ,则 (依据 2,3)
- 分解规则:若 且 ,则 (依据 1,3)
范式
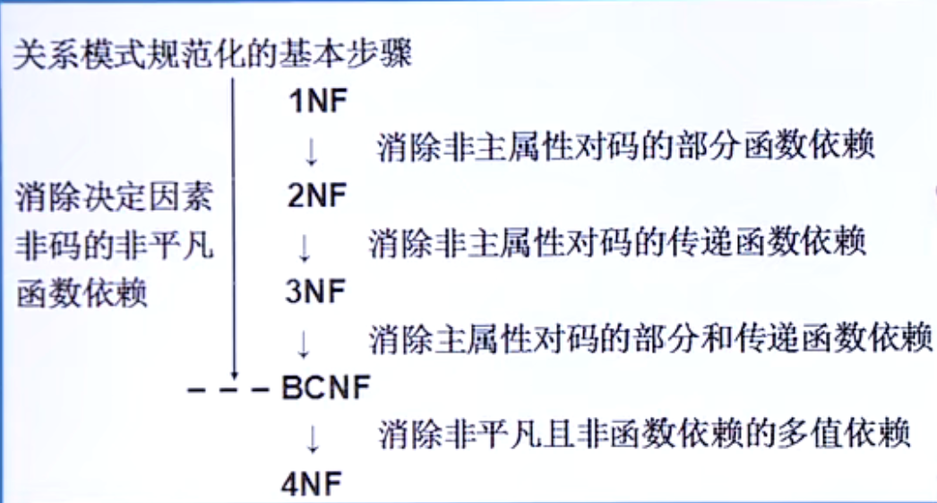
事务的特性(ACID 特性)
- 原子性(Atomicity):事务中的所有操作要么都做,要么都不做,不可分割。设计时用**影子拷贝(浅拷贝)**实现。
- 一致性(Consistency):事务执行的结果必须是使数据库从一个一致性状态变到另一个一致性状态。设计时用完整性约束检查实现。
一致性状态:数据库中只包含执行成功的事务提交的结果
不一致状态:数据库系统运行时发生故障,导致部分事务尚未完成就被迫中断;这些未完成的事务对数据库做出的修改有一部分已经回写到磁盘,此时数据库就处于一种不正确的状态
- 隔离性(Isolation):一个事务的执行不能被其他事务干扰,一个事务内部的操作及其使用的数据对其他并发操作而言是相互隔离的,并发执行的各个事务之间不能相互干扰
- 持续性(Permanence):一个事务一旦提交,其对数据库中数据造成的改变就应当是永久性的。接下来的其他操作和故障都不应该对其造成影响
分布式数据库
透明性
- 分片透明是指用户或应用程序不需要知道逻辑上访问的表具体是怎么分块存储的。
- 复制透明是指采用复制技术的分布方法,用户不需要知道数据是复制到哪些节点,如何复制的。
- 位置透明是指用户无须知道数据存放的物理位置。
- 逻辑透明,即局部数据模型透明,是指用户或应用程序无须知道局部场地使用的是哪种数据模型。
特性
| 特性 | 含义 | 例子 |
|---|---|---|
| 分布性 | 数据分布在多个不同节点/场地 | 北京、上海、广州各有自己的数据库 |
| 共享性 | 各节点的数据可以被整个系统访问和使用 | 北京网点可以查询上海客户的账户信息 |
| 可用性 | 某个节点故障时,系统仍尽量能工作 | 上海服务器宕机,北京系统仍可继续提供部分服务 |
| 自治性 | 每个节点具有一定独立处理能力 | 北京本地客户办理业务时,不需要上海数据库参与 |
分布式数据库系统的模式结构
- 全局外模式(不同人看到的不一样):类比传统数据库外模式,不同用户或应用程序看到的数据库视图。
- 全局概念模式(总体长什么样):把底层的分布隐藏起来,给用户一个统一的逻辑数据库。
- 分片模式(怎么拆):规定数据怎么拆
- 分布模式(拆完放哪):数据片到物理节点之间的映射。
数据仓库
- 四大特点:
- 面向主题:数据按主题组织。
- 集成的:消除了源数据中的不一致性,提供整个企业的一致性全局信息。
- 相对稳定的 (非易失的):主要进行查询操作,只有少量的修改和删除操作(或是不删除)。
- 反映历史变化 (随着时间变化):记录了企业从过去某一时刻到当前各个阶段的信息,可对发展历程和未来趋势做定量分析和预测。
数据库转储方式
- 静态转储需要在转储过程中锁定数据库,阻止任何事务的执行,直到转储完成。这对于大型、繁忙的数据库来说是不可行的,因为它会导致服务中断。
- 动态转储则不需要锁定整个数据库,可以在不影响正常事务处理的情况下进行数据复制。
- 全局转储是转储整个数据库的状态,包括所有数据和事务日志,这通常用于创建数据库的完整备份。
- 增量转储只转储自上次转储以来发生变化的数据,这种方式可以节省存储空间,但恢复数据时需要多次转储的日志。
技术相关
与 MySQL 查询缓存相比,使用 Memcached 机制存在以下优势:
(1) 缓存架构:数据库查询缓存通常每个数据库只有一个实例,因此存储内容受数据库服务器可用内存限制,可缓存数据有限;而 Memcached 可采用高速分布式缓存服务器结构,不受数据库服务器约束,可扩展性更好。
(2) 缓存有效性:数据库查询缓存只要在发生写操作时就会失效,即使更新的是数据库中的其他行;而 Memcached 可通过键值将数据进行散列缓存,有效降低缓存的更新频率,从而提高缓存的有效性。
(3) 缓存数据类型:数据库杏询缓存只能缓存数据库行,对社交网站好友动态显示等典型业务所需要的组合数据缓存缺乏有效支持,而 Memcached 理论上可缓存任何内容,因此可以将分散在数据库中的关系或者列表组合后进行缓存,以提高缓存数据的针对性和效率。
关系型数据库管理系统和文件系统存储方式比较
| 文件系统 | 关系型数据库 |
|---|---|
| 针对特定应用系统设计,难度较小 | 数据结构需要符合关系模式,设计难度较大 |
| 数据冗余较大,可能在多个文件中复制相同的数据属性 | 遵守数据库范式,数据冗余较少 |
| 以应用系统为中心组织、管理数据 | 以数据库为中心组织、管理数据 |
| 符合特定应用系统要求的文件数据很难在不同的应用系统之间共享 | 数据独立于应用系统,很容易在不同的应用系统之间共享数据 |
关系型数据库和内存数据的主要特点如下:
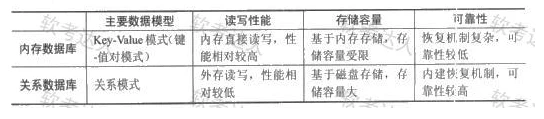
SQL 语句设计时,影响查询效率的设计原则是:
- 查询时尽量不要返回不需要的行、列;
- 需要进行多表连接査询时,尽量使用连接查询,避免使用子查询结构;
- 尽量避免采用 NOTIN、NOTEXIST、LIKE 等使用全表查询的操作;
- 尽量避免使用 DISTINCT 关键字
数据持久层:根据分层思想,通过建立逻辑数据操作接口,采取一定的对象/关系映射策略,隐藏数据库访问代码细节,向业务开发人员提供透明的对象持久化操作机制。能够为项目开发带来的好处:
- 分离业务逻辑层和数据层,降低两者之间的耦合;
- 通过对象/关系映射向业务逻辑提供面向对象的数据访问;
- 简化数据层访问,隐藏数据库连接、数据读写命令和事务管理细节。
数据持久层技术
| 技术方案 | 实现技术 |
|---|---|
| JDBC | SpringJdbcTemplate |
| SQL Mapping | iBatis/MyBatis |
| ORM | TopLink,JDO,Hibernate |
| Entity Bean | BMP, CMP |
Hibernate 框架:
- 支持多种不同类型数据库
- 支持对象的继承和聚合等立体化关系
Elasticsearch
分词原理:将输入的文本字符串切分成独立的词汇单元 (Token),以便在索引和查询时进行有效的匹配。分词过程通常包括字符过滤(如去除标点符号、停用词等)、词汇切分和词汇归一化(如转换为小写)等步骤。
为实现自定义分词器以满足特定业务需求,可以通过 Elasticsearch 的插件机制或配置自定义分析器来实现。自定义分析器可以包括自定义的字符过滤器、分词器和词汇过滤器。例如,针对在线教育这个特定领域的专业术语,可以创建自定义词汇表,并在分词过程中优先匹配这些术语,以确保搜索结果的准确性。此外,还可以根据业务需求调整分词策略,如基于统计的分词方法或基于规则的分词方法。
四种分词器:
- Standard 分词器是基于语法的分词方法,通常适用于大多数语言。它通过识别标点符号、空格以及语言特定的语法规则来确定词语边界。
- Simple 分词器是一种较为基础的分词方法,它的主要功能是按照非字母字符(包括空格、标点符号等)来分割文本。
- Whitespace 分词器的工作原理是最直接的,它仅通过空格来区分词汇单元。
- Keyword 分词器并不真正执行分词操作,而是将整个输入文本作为一个整体返回,不做任何拆分。
从 MySQL 同步数据到 Elasticsearch 的方法:
- 基于 binlog 的数据同步方法。这种方法的优点是灵活性高,可以精确地控制需要同步的数据。常见的工具如 Logstash、Canal 等都可以利用这种方式实现 MySQL 到 Elasticsearch 的数据同步。
- 基于 MySQL 的插件同步方法。一些插件能够直接在 MySQL 中捕获数据变更,并将其同步到 Elasticsearch。如 go-mysql-elasticsearch。
- 同步双写方法。在 MySQL 中进行数据修改操作时,同时将这些修改写入 Elasticsearch。
- 异步双写方法。在 MySQL 中进行数据修改操作时,把修改操作先写入 MQ 等消息中间件,再从 MQ 中写入 Elasticsearch。
- 定时任务同步方法。通过定时任务(如 Cron Job) 结合 SQL 查询与批量导入的方式实现数据的定期同步。
NoSQL
- MongoDB 可以通过 GeoJSON 格式来存储空间矢量数据。是一种基于 JSON 的地理空间数据交换格式。在 MongoDB 中,可以使用 geometry 字段来存储几何形状,使用 coordinates 字段来存储几何形状的坐标。
| 分类 | 场景 | 数据模型 | 优点 | 缺点 | 举例 |
|---|---|---|---|---|---|
| 键值对 | 内容缓存 | Key-Value,Hash 表实现 | 查找快 | 数据无结构化,只当做字符串/二进制 | Redis,Tokyo Cabinet,Oracle BDB |
| 列式存储数据库 | 分布式的文件系统 | 列簇式存储,将同一列数据存在一起 | 查找快,扩展性强,容易分布式扩展 | 功能相对局限 | HBase,Cassandra,Riak |
| 文档型数据库 | Web 应用,类似 KV,但 V 是结构化的 | KV 对,V 是结构化数据 | 数据结构要求不严格 | 查询性能不高,缺乏统一语法 | CouchDB,MongoDB |
| 图数据库 | 社交网络、推荐系统 | 图结构 | 图算法 | 有时对整个图做计算才能得到信息,不好做分布式集群 | Neo4j |
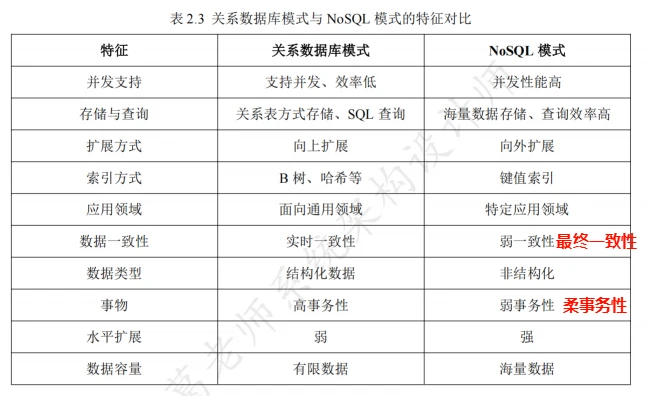
计算机网络
- 标准以太网的最大数据载荷通常是 1500 Bytes(MTU = 1500),
- ≤ 1500:表示数据字段的长度,单位字节
- ≥ 1536(0x0600):表示数据帧的类型,也就是 EtherType
- 1501~1535:保留/未定义区间
也可当做大于 1500 就表示数据帧的类型
- 计算机网络的功能:数据通信;资源共享;管理集中化;实现分布式处理;负载均衡。
- 网络中的时延由以下部分组成:发送时延、传播时延、处理时延、排队时延。
- 域名解析:
- 递归查询:服务器必须回答目标 IP 与域名的映射关系。递归查询会向下探索,最终返回答案。
- 迭代查询:服务器收到一次迭代查询回复一次结果,这个结果不一定是目标 IP 与域名的映射关系,也可以是其他 DNS 服务器的地址。迭代查询不会向下探索,会立即返回消息,可以只返回线索。
硬件设备
| 设备 | OSI 层次 | 转发依据 | 主要连接对象 | 核心作用 |
|---|---|---|---|---|
| 网桥 Bridge | 数据链路层 L2 | MAC 地址 | 局域网的不同网段 | 根据 MAC 过滤、转发帧 |
| 交换机 Switch | 数据链路层 L2 | MAC 地址 | 多台主机/多个局域网段 | 本质上是多端口网桥 |
| 路由器 Router | 网络层 L3 | IP 地址 | 不同 IP 网络 | 根据路由表转发 IP 分组 |
- 集线器 Hub:工作在物理层 L1,不认识 MAC 地址。节点集中在以它为中心的节点上,在网络中只起到信号发送和放大分发的作用,实际上就是一个中继器。由于集线器采用 CDMA/CD 介质访问控制方式,当一个节点发送数据时,与集线器相连的所有节点都可能接收到数据,因此通过集线器连接的一组工作站形成了一个冲突域。
- 交换机隔离冲突域(每个端口都是独立的),路由器隔离广播域(局域网和局域网之间)。
- 中继器:可以连接不同物理介质、可以识别并再生信号、工作在物理层,需要保证各分支的数据包和逻辑链路协议相同
交换机
| 目的 MAC 情况 | 交换机行为 |
|---|---|
| MAC 表中有记录 | 定向转发 |
| MAC 表中没有记录 | 泛洪 |
| 目的 MAC 就在帧进入的那个端口 | 丢弃,不再转发 |
泛洪:向同一 VLAN 内除入端口之外的所有端口转发。
- 交换机的初始 MAC 地址表为空
- 交换机通过读取输入帧中的源地址来添加相应的 MAC 地址表项
- 交换机的 MAC 地址表项是动态增长的
OSI 模型
- 物理层(中继器):为数据链路层提供物理连接以及它们的机械、电气、功能和过程特性。传输单位 bit。
- 以太网在物理层使用曼彻斯特编码进行数据传输。
- 数据链路层(网桥、交换机、网卡):负责在两个相邻结点间的线路上无差错地传输帧数据,并进行流量控制。传输的数据单位是帧
- 网络层(路由器):将数据链路层的帧数据组成数据包,数据包中有源网络地址和目的网络地址,主要提供路由选择功能,除此之外还有差错检测和恢复、流量/拥塞控制、激活和终止网络连接等功能。传输的数据单位是数据包。
- 传输层:为会话层提供透明、可靠的端到端的数据传输服务。其功能有数据分段、数据传输、数据组装、差错控制、流量/拥塞控制等。传输的数据单位报文
- 会话层:为表示层提供建立、维护和结束会话连接的功能,提供会话管理功能。传输的数据单位是报文。
- 表示层:提供格式化的表示和转换数据服务,如数据的压缩、解压缩、加密和解密等。
- 应用层:面向用户服务,提供网络与用户应用软件之间的接口服务,如文件传输、电子邮件、远程登录等
- 其中除第 5 层 (会话层) 外,每一层均能提供相应的安全服务。最适合配置安全服务的是在物理层、网络层、运输层及应用层上,其他层都不宜配置安全服务。
协议
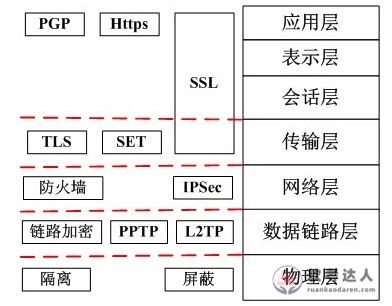
IPV4/6
- 区分服务要求每个 IP 分组都要根据 IPv4 协议头中的服务类型(在 IPv6 中是通信类型)字段加上一个DS 码点,然后内部路由器根据 DS 码点的值对分组进行调度和转发。
- IPv6 地址增加到128 位,并且能够支持多级地址层次
- 地址自动配置功能简化了网络地址的管理
- 在组播地址中增加了范围字段,改进了组播路由的可伸缩性
- 增加的任意播地址比 IPv4 中的广播地址更加实用。
- IPv6 地址被分配到接口,而不是分配给结点
- 三种类型:单播、组播、任意播(泛播)
- 一个接口可以被赋予任何类型的多个地址 (单播、任意播、组播) 或地址范围。
- IPv6首部有下列改进:
- 分组头格式得到简化:IPv4 头中的很多字段被丢弃,IPv6 头中字段的数量从 12 个降到了 8 个,中间路由器必须处理的字段从 6 个降到了 4 个,这样就简化了路由器的处理过程,提高了路由选择的效率。
- 改进了对分组头部选项的支持:与 IPv4 不同,路由选项不再集成在分组头中,而是把扩展头作为任选项处理,仅在需要时才插入到 IPv6 头与负载之间。这种方式使得分组头的处理更灵活,也更流畅。以后如果需要,还可以很方便地定义新的扩展功能。
- 提供了流标记能力:IPv6 增加了流标记,可以按照发送端的要求对某些分组进行特别的处理,从而提供了特别的服务质量支持,简化了对多媒体信息的处理,可以更好地传送具有实时需求的应用数据
- 在 IPv6 无状态自动配置过程中,主机将其MAC 地址附加在地址前缀 1111 1110 10 之后,产生一个链路本地地址。
TCP/IP
TCP/UDP
- 传输层协议
- TCP 端口号的作用是对应用层进程的寻址
ARP/RARP
根据 IPv 4 地址,找到同一局域网内对应设备的 MAC 地址。Windows 中的 arp -a/d/r/s <ip> <mac> 命令主要就是管理 ARP 缓存表:
| 命令 | 作用 | 记忆 |
|---|---|---|
arp -a | 显示 ARP 缓存表 | a = all,查看 |
arp -d | 删除 ARP 表项 | d = delete |
arp -s | 手工添加静态 ARP 表项 | s = set/static |
IGMP
IGMP 专门用于 IP 组播(Multicast),负责管理主机对组播组的加入、退出
DHCP
全程动态主机配置协议(Dynamic Host Configuration Protocol)
- 客户机/服务器模型(C/S)
- 租约默认为 8 天
- 当租约过半,客户机需要向 DHCP 服务器申请续租
- 租约超过 87.5% 时,如果仍然没有和当初提供 IP 的 DHCP 服务器联系上,则开始联系其他的 DHCP 服务器
- 分配方式:
- 固定分配(静态绑定固定 IP)
- 动态分配(租期无限长)
- 自动分配(有一定期限)
- DHCP 服务器的服务功能默认关闭
- DHCP 服务器可以管理多个网段
- 一个园区网可以存在多个 DHCP 服务器
- DHCP 客户端收到 DHCP 服务器回应的 DhcpAck 报文后,通过地址冲突检测发现服务器分配的地址冲突或者由于其他原因导致不能使用,则发送 DhcpDecline 报文,通知服务器所分配的 IP 地址不可用。
DHCP 获取 IP 地址的过程
Discover → Offer → Request → ACK也就是:客户端找服务器 → 服务器给方案 → 客户端选方案 → 服务器正式确认
| 顺序 | DHCP 报文 | 发送方向 | 作用 |
|---|---|---|---|
| 1 | DHCP Discover | 客户端 → 服务器 | 客户端刚接入网络,不知道 DHCP 服务器在哪,于是广播:“有没有 DHCP 服务器?我需要一个 IP。” |
| 2 | DHCP Offer | 服务器 → 客户端 | DHCP 服务器收到 Discover 后,提供一个可用 IP 地址以及掩码、网关、租期等参数 |
| 3 | 客户端会发送 ARP 请求来检测网络中是否有其他设备使用了该 IP 地址。 | ||
| 4 | DHCP Request | 客户端 → 服务器 | 客户端从收到的 Offer 中选择一个,告诉服务器:“我就申请你提供的这个 IP。” |
| 5 | DHCP ACK | 服务器 → 客户端 | 服务器确认申请,把该 IP 正式租给客户端 |
| — | DHCP Decline | 客户端 → 服务器 | 异常情况:客户端发现服务器给的 IP 已经被占用,告诉服务器“这个地址有冲突,我不能用” |
| — | DHCP NACK | 服务器 → 客户端 | 异常情况:服务器拒绝客户端的 Request,例如申请的 IP 已无效或不属于当前网段 |
SET
SET(Secure Electronic Transaction) 协议,全称为安全电子交易协议,主要目的是保证用户、商家和银行之间通过信用卡支付的交易过程中的支付信息的机密、支付过程的完整、商户及持卡人的合法身份确认。
电子邮件
PGP、MOSS
- 安全电子邮件协议:PGP
- 交互式邮件存取协议:IMAP(端口 143)
网关协议
- IGP = 内部网关协议:用于一个自治系统 AS 内部的路由选择。
- OSPF:链路状态协议
- RIP、IS-IS、EIGRP
- EGP = 外部网关协议:用于不同自治系统 AS 之间的路由选择。早期外部网关协议,现已基本淘汰。
- BGP:运行在 TCP 之上,使用 TCP 179 端口,但 TCP 不是路由协议。
- 管理距离是指一种路由协议的路由可信度。一个管理距离是一个从 0-255 的整数值,0 是最可信赖的,而 255 则意味着不会有业务量通过这个路由。
其他协议
- BGP:外部网关协议
- STP(生成树协议,用于解决环路问题)
- OSPF(路由协议)
常用端口
| 应用 | 协议 | 端口 | 功能 |
|---|---|---|---|
| FTP | TCP | 20(数据),21(控制) | |
| TFTP | UDP | 69 | 简单文件传输 |
| SMTP | TCP | 25 | 邮件发送 |
| POP 3 | TCP | 110 | 邮件收取 |
| Telnet | TCP | 23 | |
| DNS | UDP | 53 | |
| DHCP | UDP | 67 | 动态 IP 配置 |
| SNMP | UDP | 161 | 网络管理 |
| IMAP | 143 | 交互式邮件存取协议 |
IP 计算
某公司网络的地址是
192.168.192.0/20,要分成 32 个子网,则子网掩码为 ( )?每个子网可分配的主机地址数是 ( )?
192.168.192.0/20 为 IP-CIDR 格式,/20 表示前 20 位不变,即网络号。
32 个子网,即 ,因此需要 5 位表示子网号。
综上,子网掩码(网络号 + 子网号)一共占据 20+5=25 位,为 255.255.255.128。
32-25=7 位,因此主机号为 7 位(意为可以给 台主机分配不同的 IP 地址)。
0.0.0.0(本地地址) 和 255.255.255.255(广播地址)不可作为主机号,因此每个子网可分配的主机地址数为 个。
关于另一类,直接给出子网掩码的题目,实为上方类型的反向操作。例如:
给定 IP 地址为
140.252.12.120,子网掩码是255.255.255.0,那么主机号是( ),该子网直接的广播地址是( )。
根据子网掩码,将每个 IP 地址数通过除 2 取余法转化为二进制数,得到网络号 + 子网号为前 24 为,即 /24,
因此,余下 32-24=8 位表示主机号。求解具体主机号时,只保留“主机位”,网络位全部变成 0,即 0.0.0.120。
网络号的计算同理,将主机位置为 0,剩下的即为网络位,本题为 140.252.12.0/24。
广播地址将主机位全部置为 1,因此变为 140.252.12.255。
A/B/C 子网划分问题
分配给某公司网络的地址块是
210.115.192.0/20,该网络可以被划分为( )个 C 类子网。
C 类网络默认子网掩码是 255.255.255.0,也就是 /24 。/20 表示 20 位网络位,还需要从剩下的主机位中拿出 4 位用于划分子网,因此 ,即能表示 16 个 C 类子网。
网络拓扑结构
- 星型:传输速度快、便于控制和管理、建网容易,但可靠性低,网络共享能力差,并且一旦中心结点出现故障则导致全网瘫痪。
- 全分布型:抗毁性能好、移动能力强、适合中小型网络,无中心结点,每一结点仅拥有网络的部分拓扑信息。
- 总线型中所有节点通过一条公共总线连接(共享传输介质),同一时间内仅允许一个节点发送数据,否则会产生冲突。
- 网状结构具有多路径冗余。
VLAN
VLAN = 在一台或多台交换机上,逻辑地划分多个独立的广播域。也就是说,不必按照物理位置来分网段,而可以通过交换机配置,把不同端口/主机逻辑上分成不同的 LAN。
- VLAN 主要处理的是广播域,不是冲突域。
- VLAN 与冲突域大小没有关系。每个交换机端口就是一个独立冲突域。
- VLAN 增加广播域的数量,缩小每个广播域的范围。
网络规划与设计
网络规划:包括网络需求分析、可行性分析以及对现有网络的分析。
| 阶段 | 操作 | 产物 |
|---|---|---|
| 需求分析 | 确定需求,包括:业务需求、用户需求、应用需求、计算机平台需求、网络通信需求等 | 需求规范 |
| 通信规范分析 | 现有的网络体系分析,估计和测量通信量及设备利用率。 | 通信规范 |
| 逻辑网络设计 | 选择符合需求的设计,确定网络逻辑结构。 | 逻辑设计文档 |
| 物理网络设计 | 将逻辑设计应用到物理空间,确定网络物理结构。 | 物理结构设计文档 |
| 实施阶段 | 实现物理网络设计,安装和维护。 |
上表即为网络系统生命周期 5 个阶段的顺序
逻辑网络设计
利用需求分析和现有网络体系分析的结果来设计逻辑网络结构,最后得到一份逻辑网络设计文档,输出内容包括以下几点:
- 逻辑网络设计图
- IP 地址方案
- 安全方案
- 招聘和培训网络员工的具体说明
- 对软硬件、服务、员工和培训的费用初步估计。
逻辑网络设计工作包括以下内容: (1) 网络结构的设计 (2) 物理层技术的选择 (3) 局域网技术的选择与应用 (4) 广域网技术的选择与应用 (5) 地址设计和命名模型 (6) 路由选择协议 (7) 网络管理 (8) 网络安全 (9) 逻辑网络设计文档
物理网络设计
对逻辑网络设计的物理实现,通过对设备的具体物理分布、运行环境等确定,确保网络的物理连接符合逻辑连接的要求。输出如下内容:
- 网络物理结构图和布线方案
- 设备和部件的详细列表清单
- 软硬件和安装费用的估算
- 安装日程表,详细说明服务的时间以及期限
- 安装后的测试计划
- 用户的培训计划
城域网分层设计
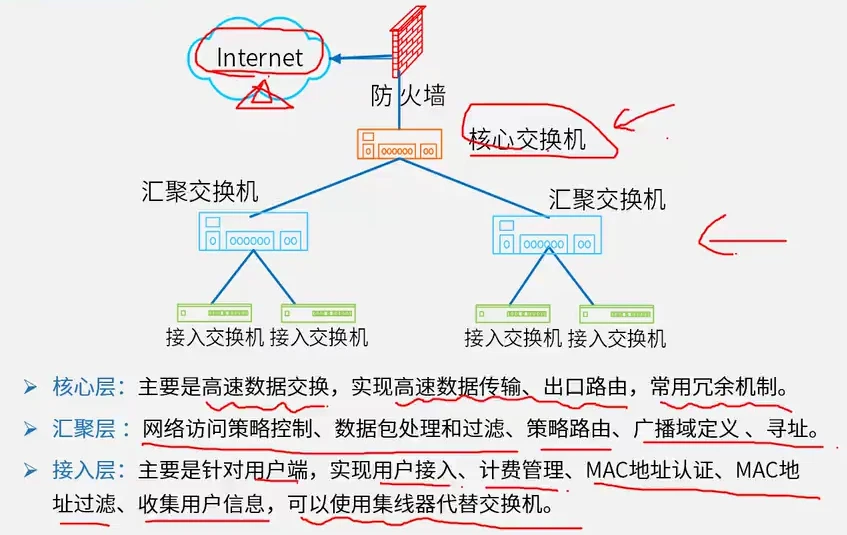
网络存储系统
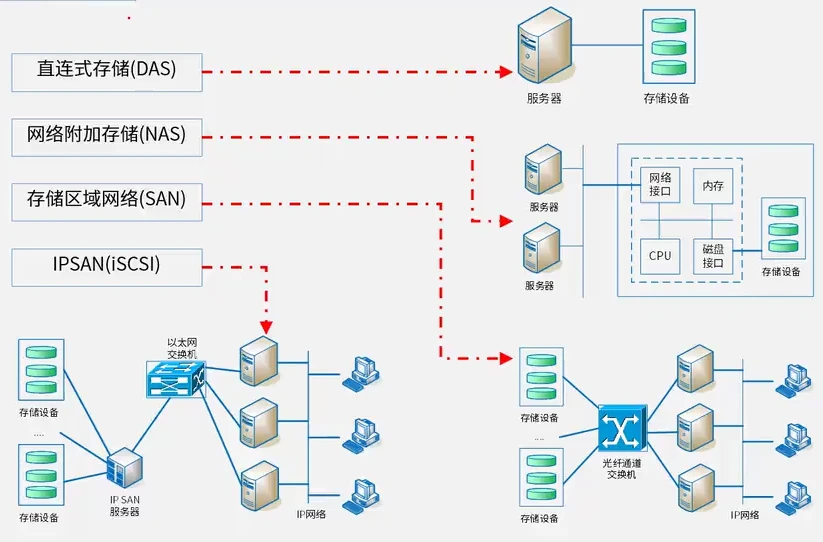
- 直连式存储 DAS:存储设备通过 SCSI 直接与服务器连接
- 网络附加存储 NAS:通过网络接口与网络直接连接
- 存储区域网络 SAN:通过专用高速网络连接,主要是以太网(IP SAN)和光纤通道(FC SAN)
- IPSAN:基于 IP 网络实现(就是网线连起来)
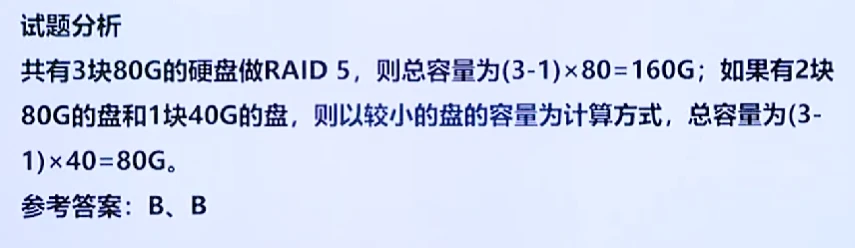
RAID
| 阵列 | 结构 | 磁盘利用率 | 可用容量(单盘) |
|---|---|---|---|
| Raid0 | 一块盘,速度最快,损坏无法恢复 | 100% | 1 |
| Raid1 | 两块盘,其中一个做备份 | 50% | 1 |
| Raid3 | N+1 模式,有固定的校验盘,坏一个盘可恢复 | n-1 | |
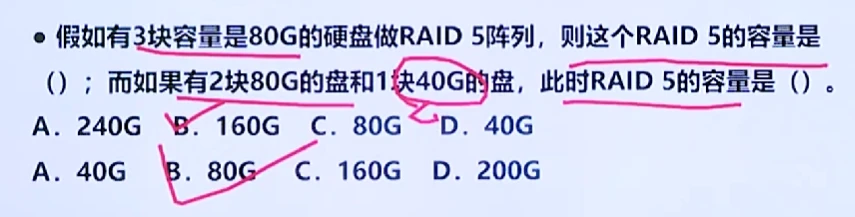
| Raid5 | N+1 模式,无固定的校验盘,坏一个盘可恢复 | n-1 | |
| Raid6 | n-2 | ||
| Raid10 | 必须偶数块盘,一半容量用于镜像 | 50% | n/2 |
综合布线系统
- 工作区子系统由信息插座、插座盒、连接跳线和适配器组成。
- 水平子系统由一个工作区的信息插座开始,经水平布置到管理区的内侧配线架的线缆所组成。
- 垂直干线子系统由建筑物内所有的垂直干线多对数电缆及相关支撑硬件组成,以提供设备间总配线架与干线接线间楼层配线架之间的干线路由。
- 管理子系统由交连、互连配线架组成。管理子系统为连接其它子系统提供连接手段。
- 设备间子系统是由设备间中的电缆、连接器和有关的支撑硬件组成,作用是将计算机、PBX、摄像头、监视器等弱电设备互连起来并连接到主配线架上。
- 建筑群子系统将一个建筑物的电缆延伸到建筑群的另外一些建筑物中的通信设备和装置上,是结构化布线系统的一部分,支持提供楼群之间通信所需的硬件。它由电缆、光缆和入楼处的过流过压电气保护设备等相关硬件组成,常用介质是光缆。
省流版本:
| 子系统 | 人话 |
|---|---|
| 工作区 | 你的房间 |
| 水平 | 一层楼 |
| 管理 | 配线架 |
| 垂直 | 多层楼之间 |
| 设备间 | 顾名思义,设备间 |
| 建筑群 | 很多栋楼 |
数字发信机
一个典型数字发信机的大致流程理解成:
信源 → 信源编码(模数转换) → 信道编码 → 交织 → 调制 → 高频载波发送- 信源编码:把模拟信号变成数字信号(ADC),压缩、减小带宽需求
- 信道编码:纠错
- 交织:把连续出现的一串错误“打散”,解决连续误码问题
- 调制:将信息承载到高频载波(QAM)
香农公式&奈奎斯特
香浓公式回答的是:**有噪声信道最多能以多大的速率可靠传输数据?**各符号含义是:
- C:信道的最大数据传输速率/信道容量,单位 bit/s
- B:信道带宽,单位 Hz
- S:信号功率
- N:噪声功率
- S/N:信噪比,注意这里要求用数值比,不是 dB
奈奎斯特采样定理:要想对模拟信号进行无失真恢复,采样频率至少应为信号最高频率的 2 倍。
奈奎斯特公式:用来计算理想无噪声信道的最大数据传输速率。
其中:
- C:最大数据传输速率,bit/s
- B:信道带宽,Hz
- M:每个码元可取的物理状态数
某信道的带宽为 3000Hz,编码采用 32 种不同的物理状态来表示数据,在无噪声环境下,该信道的最大数据传输速率是( )kbps。
各类耦合
| 耦合类型 | 特征 | 例子 |
|---|---|---|
| 数据耦合 | 只传递简单数据 | f(x, y) |
| 标记耦合 | 传递整个数据结构 | 传整个结构体/记录 |
| 控制耦合 | 传递控制信息 | flag=1 决定对方怎么执行 |
| 外部耦合 | 共同依赖外部接口/格式 | 同一设备、协议、文件格式 |
| 公共耦合 | 共同访问全局数据 | 共享全局变量、公共数据区 |
| 内容耦合 | 一个模块直接操作另一个模块内部 | 直接修改另一模块内部数据 |
移动通信
| 技术 | 全称 | 核心思想 | 可以怎么理解 | 代际 |
|---|---|---|---|---|
| FDMA | Frequency Division Multiple Access,频分多址 | 不同用户分不同的频率 | 你一个频道,我一个频道 | 1G |
| TDMA | Time Division Multiple Access,时分多址 | 不同用户分不同的时间片 | 同一个频道,轮流讲话 | 2G |
| CDMA | Code Division Multiple Access,码分多址 | 不同用户使用不同的编码 | 大家同时讲话,但用不同“暗号”区分 | 3G |
| TD-LTE | Time Division LTE,时分双工 LTE | 上行、下行在同一频段,按时间分开 | 一会儿上传,一会儿下载 | 4G |
| FDD-LTE | Frequency Division LTE,频分双工 LTE | 上行、下行使用不同频段 | 一个频段上传,另一个频段下载 | 4G |
5G
5G 网络的主要特征是:
- SBA 服务化架构:实现网络功能灵活定制和按需组合。
- 网络切片:可在同一物理网络上划分多个逻辑网络、每个切片都是独立的端到端网络、每个切片都有自己独特的安全特性、网络切片可以灵活应对不同需求
计算机语言
UML
5 个系统视图:
- 用例视图是最基本的需求分析模型,居于五类视图的中心地位。面向所有相关人员。
- 逻辑视图(设计视图)表示了设计模型中在架构方面具有重要意义的部分,即类、子系统、包和用例实现包和用例实现**的子集。面向系统分析和设计人员。
- 进程视图是可执行线程和进程作为活动类的建模,它是逻辑视图的一次执行实例,描述了并发与同步结构。面向开发者和系统集成者。
- 实现视图对组成基于系统的物理代码的文件和组件进行建模。面向设计者、开发者和测试者。
- 部署视图把组件部署到一组物理节点上,表示软件到硬件的映射和分布结构。
类图展现了一组对象、接口、协作和它们之间的关系。 定时图强调消息跨越不同对象或参与者的实际时间,而不仅仅只是关心消息的相对顺序。 部署图软件和硬件组件之间的物理关系以及处理节点的组件分布情况。 包图描述由模型本身分解而成的组织单元,以及它们之间的依赖关系。
交互图包括交互概览图、定时图(计时图)、顺序图(序列图)与通信图(协作图),除此以外,动态模型还包括状态图和活动图等。
4 种事物:
- 结构事物是 UML 模型中的名词。它们通常是模型的静态部分,描述概念或物理元素;
- 行为事物是 UML 模型的动态部分。它们是模型中的动词,描述了跨越时间和空间的行为;
- 分组事物是 UML 模型的组仅部分。它们是—些由模型分解成的盒子;
- 注释事物是 UML 模型的解释部分。这些注释事物用来描述、说明和标注模型的任何元素。
UML 有两种主要的行为事物,分别是:交互和状态机。
- 用例图的三种关系:
- 包含关系。当可以从两个或两个以上的用例中提取公共行为时,应该使用包含关系来表示它们。其中这个提取出来的公共用例称为抽象用例,而把原始用例称为基本用例或基础用例。
- 扩展关系。如果一个用例明显地混合了两种或两种以上的不同场景,即根据情况可能发生多种分支,则可以将这个用例分为一个基本用例和一个或多个扩展用例,这样使描述可能更加清晰。
- 泛化关系。当多个用例共同拥有一种类似的结构和行为的时候,可以将它们的共性抽象成为父用例,其他的用例作为泛化关系中的子用例。在用例的泛化关系中,子用例是父用例的一种特殊形式,子用例继承了父用例所有的结构、行为和关系。
- 面向对象设计的基本任务,把面向对象分析模型转换为面向对象设计模型。
- 面向对象的分析模型主要由顶层架构图、用例与用例图、领域概念模型构成。
- 设计模型则包含以包图表示的软件体系结构图、以交互图表示的用例实现图、完整精确的类图、针对复杂对象的状态图和描述流程化处理过程的活动图等。
- 在 UML 中,需求分析常用的图包括用例图、活动图和类图。
状态图和活动图
状态图主要用于描述一个对象在其生存期间的动态行为,表现一个对象所经历的状态序列,引起状态转移的事件(event),以及因状态转移而伴随的动作(action)。
活动图可以用于描述系统的工作流程和并发行为。活动图其实可看作状态图的特殊形式,活动图中一个活动结束后将立即进入下一个活动(在状态图中状态的转移可能需要事件的触发)。
两者最大的区别是:
- 状态图侧重于描述行为的结果,而活动图侧重描述行为的动作。
- 活动图可描述并发行为,而状态图不能。
时序图和协作图
也叫:顺序图、序列图。序列图的基本元素:对象、生命线和消息,还有两种元素是激活(控制焦点)和交互(序列)片段LDERmvrqqqxhv2kw33em}交互(序列)片段**。
顺序图中,如果只是普通的对象之间按时间先后发送消息,直接画消息箭头即可;但如果出现了 if/else、循环、并行等复杂、控制逻辑,就需要用交互片段把这部分交互框起来。激活表示对象正在执行某个动作或处于活动状态的时间段。
时序图的三种消息:
- 同步消息:消息的发送者把控制传递给消息的接收者,然后停止活动,等待消息的接收者放弃或者返回控制。用来表示同步的意义。
- 异步消息:消息发送者通过消息把信号传递给消息的接收者,然后继续自己的活动,不等待接受者返回消息或者控制。异步消息的接收者和发送者是并发工作的。
- 返回消息:返回消息表示从过程调用返回。
- 参与者创建消息
- 参与者销毁消息
时序图的选取原则:
- 强调时间顺序:适用于展示对象之间消息传递的时间顺序和动态行为,描述系统中的事件发生顺序。
- 展示交互的时间线:清晰展示用例或场景中各对象在不同时间点的状态变化,帮助理解系统的时间维度行为。
- 描述复杂的交互场景:适用于多个对象和复杂交互的场景,通过时间线展示消息传递的先后顺序,使复杂交互过程易于理解。
协作图的选取原则:
- 强调对象间的关系:展示对象之间的链接和关系结构,适用于静态连接和通信路径的展示。
- 展示对象的结构关系:描述对象如何协作完成任务,强调对象之间的静态结构和协作方式。
- 突出对象间的通信:适用于展示对象间的通信和交互,而不是时间顺序,清晰展示对象之间的消息传递和关联关系。
四种关系
- 依赖关系:依赖是两个事物之间的语义关系,其中一个事物发生变化会影响另一个事物的语义。
- 关联关系:关联描述一组对象之间连接的结构关系。
- 泛化关系:泛化是一般化和特殊化的关系,描述特殊元素的对象可替换一般元素的对象。
- 实现关系:实现是类之间的语义关系,其中的一个类指定了由另一个类保证执行的契约。
组合与聚合
都是整体与部分的关系,都是关联关系的特殊种类,区别在于:
- 组合:B 是 A 的一部分,但 A 消失后 B 也不存在,即强聚合。“部分”只能属于一个“整体”。
- 聚合:B 是 A 的一部分,但没有 A,B 也可以独立存在。“部分”可能同时属于多个“整体”。
多媒体
| 类型 | 是什么 | 典型例子 |
|---|---|---|
| 感觉媒体 | 人能直接通过感官感受到的信息 | 文字、声音、图像、动画、视频 |
| 表示媒体 | 计算机内部为了表示/编码这些信息所采用的数据形式 | ASCII、JPEG 编码、MP3 编码、MPEG 编码等 |
| 表现媒体 | 把信息输入计算机或输出给人的设备 | 键盘、鼠标、显示器、音箱、麦克风、打印机 |
| 存储媒体 | 用来存放信息的介质 | 硬盘、SSD、U 盘、光盘、磁带 |
Z 语言
- Z 语言是一种形式化语言,具有**“状态—操作”风格**,借助模式来表达系统结构,建立于集合论和数理逻辑的基础上。
- Z 语言可以使用自然语言和数学语言
- 是一个强类型系统
- 可以进行求精
信息系统
- 信息系统的生命周期分为四个阶段:产生阶段、开发阶段、运行阶段和消亡阶段。
- 信息系统建设的主要原则:高层管理人员介入、用户参与开发、自顶向下规划、工程化原则等,但不包括技术驱动原则。建设应该以满足业务需求和用户需求为核心,而不是单纯追求技术先进性。
- 信息系统由硬件、软件、网络通信设备、信息资源、用户及制度组成。
- 软件安全性需求是指通过约束软件的行为,使其不会出现不可接受的违反系统安全的行为。
- 软件安全需求的获取是根据已知的系统信息,如软件危害条件等以及其他一些类似的系统数据和通用惯例,完成通用软件安全性需求的裁剪和特定软件安全性需求的获取工作。
- 系统规划方法经历了三个阶段的演变:1. 第一阶段以数据处理为核心,围绕职能部门需求进行信息系统规划。2. 第二阶段以企业内部管理信息系统为核心,围绕企业整体需求进行信息系统规划。3. 第三阶段以集成为核心,在综合考虑企业内外环境的情况下,围绕企业战略需求进行信息系统规划。
信息化战略
- 关键成功因素法(CSF):对企业战略提取关键信息集合,抓住主要矛盾,确定开发优先次序
- 战略集合转化法(SST):提取企业战略目标信息集合,作为信息系统的战略目标
- 企业系统规划法(BSP):自上而下规划,自下而上实现
- 信息化需求包含 3 个层次,即战略需求、运作需求和技术需求。
- 战略需求:组织信息化的目标是提升组织的竞争能力、为组织的可持续发展提供一个支持环境。
- 运作需求:非常重要且关键的一环,它包含三方面的内容:
- 实现信息化战略目标的需要;
- 运作策略的需要。
- 人才培养的需要
- 技术需求:强调在信息层技术层面上对系统的完善、升级、集成和整合提出的需求
- 企业数字化转型的五个发展阶段:初始级发展阶段、单元级发展阶段、流程级发展阶段、网络级发展险段、生态级发展阶段
业务处理系统 TPS
TPS(Transaction Processing System),中文一般叫 业务处理系统 或 事务处理系统,是一种专门处理企业每天大量、重复、结构化业务的系统。如:银行转账、超市收银、订单处理、库存出入库、工资发放、机票订票等,都属于 TPS 的典型应用。
- TPS 处在企业信息系统的“底层”,它最先记录真实业务数据。
- TPS 往往是核心业务系统,一旦宕机可能直接导致无法交易、下单、付款
- TPS 产生大量基础业务数据,上层信息系统通常以这些数据为基础
- ERP、银行核心、POS、财务、订单等都有大量成熟商品化系统
- 使用OLTP(Online Transaction Processing,联机事务处理),用户一操作,系统马上处理,马上反馈。
管理信息系统 MIS
管理信息系统(MIS,Management Information System)把企业日常产生的各种业务数据收集起来,经过加工、汇总和分析,变成管理人员需要的信息,用来支持企业的计划、控制和管理决策。一个 MIS 可以采用一个功能/层次矩阵表示。
| 组成部分 | 是什么 | 举例 |
|---|---|---|
| 信息源 | 信息从哪里来 | TPS、订单系统、财务数据、市场数据 |
| 信息处理器 | 对信息进行加工处理 | 计算机、软件、数据库等 |
| 信息用户 | 谁使用处理后的信息 | 企业管理人员 |
| 信息管理者 | 负责 MIS 的建设、运行、维护和管理 | 信息中心、系统管理员等 |
| 结构 | 核心含义 | 关键词 |
|---|---|---|
| 开环结构 | 系统输出决策后,不根据实际执行结果再反馈调整 | 无反馈 |
| 闭环结构 | 决策执行后继续收集结果,与目标比较,再修正决策 | 有反馈、不断调整 |
| 功能结构 | 按企业的管理职能划分子系统 | 按部门/职能分 |
| 过程结构 | 按管理活动或业务流程来组织系统 | 按过程/流程分 |
决策支持系统 DSS
DSS 是一个由语言系统、知识系统和问题处理系统 3 个互相关联的部分组成的,基于计算机的系统。特征如下:
- 数据和模型是 DSS 的主要资源。
- 用来支援用户作决策。
- 主要用于解决半结构化及非结构化问题。
- 作用在于提高决策的有效性而不是提高决策的效率。
- DSS 用户是依靠模型库中的模型进行决策的。
基本结构形式
- 两库结构:
- 数据库(Database):存放决策所需要的数据,例如历史销售数据、成本数据、市场数据等。
- 模型库(Model Base):存放各种决策模型,例如预测模型、优化模型、统计模型、线性规划模型等。
- 基本工作过程:用户提出问题 → 从数据库取数据 → 调用模型库中的模型进行计算 → 给用户提供决策参考
- 基于知识的结构:
- 在传统 DSS 基础上引入人工智能/专家系统思想,加入知识库和推理机制(推理机)
3 类决策
| 决策类型 | 能否建立明确算法 | 特点 | 例子 |
|---|---|---|---|
| 结构化决策 | ✅ 可以,基本可以完全算法化 | 规则明确、流程固定 | 工资计算、库存补货计算 |
| 半结构化决策 | ✅ 部分可以算法化 | 一部分靠模型计算,一部分靠人判断 | 投资方案选择、生产计划 |
| 非结构化决策 | ❌ 很难建立固定算法 | 主要靠人的经验、判断、直觉 | 企业战略制定、是否进入新市场 |
信息资源管理 IRM
信息资源与人力、物力、财力和自然资源一样,都是企业的重要资源。因此,应该像管理其他资源那样管理信息资源。做好信息资源管理(Information Resource Management, IRM)的目的是通过企业内外信息流的畅通和信息资源的有效利用,来提高企业的效益和竞争力。
IRM 包括数据资源管理和信息处理管理。前者强调对数据的控制(维护和安全),后者则关心企业管理人员如何获取和处理信息(流程和方法)且强调企业中信息资源的重要性.
信息资源分类的主要功能是用于 IRM,而 IRM 的起点和基础是建立信息资源目录。信息资源只有科学地建立了目录,才能使信息资源得到快速、及时的存储、处理、检索和使用。信息资源分类是 IRM 中最为复杂的工作之一,应当遵循简洁、独立和可操作的原则。对信息资源的分类一般从以下三个维度来展开:(1)从管理维度分类.(2)从信息来源维度分类.(3)从应用主题维度分类。
专家系统 ES
- 专家系统可以处理数字与符号,而一般计算机系统主要处理数字。
- 专家系统多属准结构性问题,而一般计算机系统多属结构性问题。
- 专家系统的功能包括解决问题、解释结果、进行判断与决策,而一般计算机系统主要用于解决问题。
- 专家系统可以处理不确定的知识,而一般计算机系统主要处理确定的知识。
学习机制
专家系统的学习机制主要依赖其核心组成部分:知识库和推理机。
- 知识库:专家系统的核心,用于存储领域知识,包括事实和规则。通过不断更新和扩展知识库,增强系统的知识储备。
- 推理机:专家系统的推理与决策核心,负责根据知识库中的规则进行推理和问题求解。通过优化推理过程,提高系统的推理效率和正确性。
办公自动化系统 OAS
| 功能 | 主要作用 | 主要使用人员 |
|---|---|---|
| 事务处理 | 处理日常办公事务,如文字处理、文件收发、会议安排、邮件、报表等 | 基层办公人员 |
| 信息管理 | 对各种办公信息进行收集、存储、整理、查询、统计和共享 | 中层管理人员 |
| 辅助决策 | 利用信息、模型和分析工具,为重大决策提供方案、预测、分析等支持 | 企业高层及“智囊团” |
- OAS 的组成包括四个主要部分:计算机设备、办公设备、数据通信及网络设备、软件系统。
- 办公设备:电话机、传真机、电传机、复印机等。
- OAS 的核心是信息一体化处理
企业资源规划系统 ERP
- ERP (Enterprise Resource Planning) 是建立在信息技术的基础上,利用现代企业的先进管理思想,对企业的物流资源、资金流资源和信息流资源进行全面集成管理的管理信息系统,为企业提供决策、计划、控制与经营业绩评估的全方位和系统化的管理平台。
- 在 ERP 系统中,库存管理(inventory management)模块主要是对企业物料的进、出、存进行管理。
- 购买使用一个商业化的 ERP 软件,转化成本高,失败的风险也很大。ERP 的关键是事前规划管理。
- ERP 系统支持企业决策,为不同行业企业提供有针对性的 IT 解决方案,并且从企业内部供应链发展为全行业和跨行业的供应链。
- ERP 中的企业资源:物流、资金流和信息流(同信息化三流、电子商务 SCM 理念)
| 环节 | 主要回答什么问题 | 关键词 |
|---|---|---|
| 生产预测 | 市场未来可能需要多少? | 预测市场需求 |
| 生产计划大纲 | 企业总体准备生产多少? | 总体规划、综合计划 |
| 主生产计划 MPS | 具体什么产品、什么时候、生产多少? | 经营计划的细化 |
| 物料需求计划 MRP | 为完成这些产品,需要什么零部件、多少、何时需要? | 物料级计划 |
| 能力需求计划 CRP | 设备、人员、工时等产能是否够? | 能力瓶颈 |
| 采购 / 车间作业计划 | 具体怎么买、怎么加工、什么时候开工? | 执行计划 |
| 执行与反馈 | 实际执行得怎么样?是否需要调整? | 闭环反馈 |
企业集成
- 企业集成平台是一个支持复杂信息环境下信息系统开发、集成、协同运行的软件支撑环境,包括硬件、软件、软件工具和系统。基本功能包括:
- 通信服务:提供分布环境下透明的同步/异步通信服务功能;
- 信息集成服务:为应用提供透明的信息访问服务,实现异种数据库系统之间数据的交换、互操作、分布数据管理和共享信息模型定义:
- 应用集成服务:通过高层应用编程接口来实现对相应应用程序的访问,能够为应用提供数据交换和访问操作,使各种不同的系统能够相互协作;
- 二次开发工具:是集成平台提供的一组帮助用户开发特定应用程序的支持工具;
- 平台运行管理工具:是企业集成平台的运行管理和控制模块。
- 实行企业信息资源集成的前提是对企业历史上形成的企业信息功能的集成,其核心是对企业内部和外部信息流的集成,其实施的基础是各种信息手段的集成。
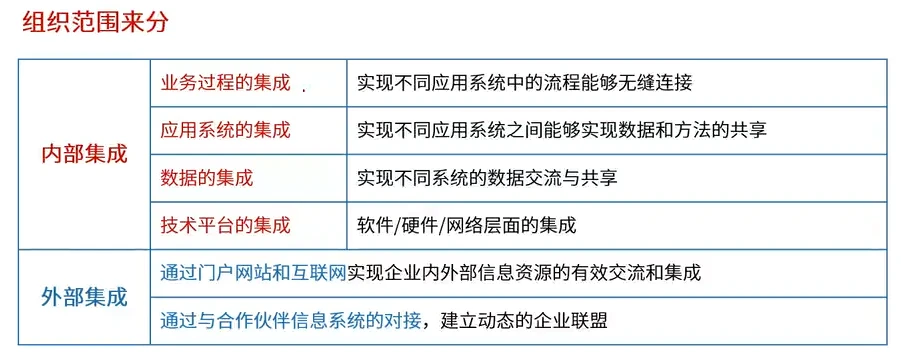
- 企业信息集成分为企业内部的信息集成和外部的信息集成两个方面。
- 企业内部的信息集成一般可分为以下四个方面:技术平台集成,数据集成,应用系统集成和业务过程集成。(数据,通过技术,形成应用,作用在业务)。应用系统集成是实现不同系统之间的互操作,使得不同应用系统之间能够实现数据和方法的共享;业务过程集成使得在不同应用系统中的流程能够无缝连接,实现流程的协调运作和流程信息的充分共享。
- 企业集成四个层次:
-
- 数据集成:最底层,解决数据的共享和统一问题。通过数据抽取、清洗、转换等方法实现数据资源的集中化或分布式管理。
-
- 会聚集成:通过整合不同的系统或模块,使它们能够协同工作。解决的是“如何整合系统资源”的问题,开始涉及逻辑和服务的整合。
-
- 服务集成:通过服务的调用和组合,支持跨系统的业务流程。引入了 SOA(面向服务的架构)和 ESB(企业服务总线)等技术,关注服务的发布、发现和调用。
-
- 应用集成:最高层次,通过整合业务应用,实现跨系统、跨部门的业务流程联动。关注整体的业务优化和用户体验。
-
企业信息化
- 企业信息化从作为管理核心的财务、物料管理,转向技术、物资、人力资源的管理,并延伸到企业技术创新、工艺设计、产品设计、生产制造过程的管理,进而还要扩展到客户关系管理、供应链管理乃至发展到电子商务。
- 人力资源是把所有员工看作是一种资本,而非部分员工。
- 企业信息化一定要建立在企业战略规划基础之上,以企业战略规划为基础建立的企业管理模式是建立企业战略数据模型的依据。
- 企业信息化就是技术和业务的融合。这个”融合“并不是简单地利用信息系统对手工的作业流程进行自动化,而是需要从企业战略的层面、业务运作层面、管理运作层面这 3 个层面来实现。
- 企业信息化建设与其说是一场技术变革,还不如说是对企业的经营管理和业务流程的一次革命,它是借助于先进的信息技术和网络技术的价值链进行重构。同时,企业信息化是一个不断发展、变化的过程,它没有终点,至少目前还看不到终点。
- 企业信息化方法并不同于信息系统建设方法,这是因为信息系统建设方法是一个具体的信息项目建设的方法,而企业信息化方法是整个企业实现信息化的方法,因此,企业信息化方法要比信息系统建设方法层次更高、涉及面更广。
- 企业信息化方法聚焦于通过技术整合优化运营体系,核心手段包括业务流程重组(改造流程提升效率)、供应链管理(整合资源网络)、人力资本投资(强化数字化能力)等,这些均直接作用于信息化能力构建。
客户关系管理系统 CRM
- CRM (Customer Relationship Management) 通过将人力资源、业务流程与专业技术进行有效的整合
- CRM 系统的主要模块包括销售自动化、营销自动化、客户服务与支持、商业智能。
- 销售自动化是最基本的模块。
- 营销自动化作为销售自动化的补充,包括营销计划的编制和执行、计划结果分析等功能。
- 客户服务与支持是 CRM 系统的重要功能。目前,客户服务与支持的主要手段有两种,分别是呼叫中心和互联网。
- CRM 系统能够与 ERP 系统在财务、制造、库存等环节进行连接,两者之间虽然关系比较独立,但由于两者之间具有一定的关系,因此会形成一定的闭环反馈结构。
- 具有整合各种客户联系渠道的能力,并把客户数据分为描述性、促销性和交易性数据三大类
- 可扩展性和可复用性
- CRM 的核心是客户价值管理。那么在开发过程中,最大程度地帮助企业实现其经营目标是开发的主要目标。
电子商务
- 供应链管理 (Supply Chain Management, SCM) 的核心目标是通过整合和优化整个供应链中的各个环节,包括供应商、制造商和零售商,来提高整体的业务效率。这种整合优化不仅仅局限于某一个环节,而是贯穿整个供应链,以实现整体效益的最大化。
- SCM 理念:信息化三流,信息流、资金流、物流
- SCM 包括计划、采购、制造、配送、退货五大基本内容。
- 商业智能(BI):
- 商业智能的核心技术包括:数据仓库、数据挖掘、联机分析处理。
- 数据预处理:数据的抽取、转换和装载,通过数据挖掘实现企业原始数据的初步整合
- 建立数据仓库:处理海量数据的基础
- 数据分析:体现系统智能的关键,一般采用 OLAP(联机分析处理)和数据挖掘技术。联机分析处理不仅进行数据汇总/聚集,同时还提供切片、切块、下钻、上卷和旋转等数据分析功能,用户可以方便地对海量数据进行多维分析。数据挖掘的目标则是挖掘数据背后隐藏的知识,通过关联分析、聚类和分类等方法建立分析模型,预测企业未来发展趋势和将要面临的问题。
- 数据展现:主要完成数据处理结果的可视化。
- 供应链中的信息流分为需求信息流和供应信息流
- 当需求信息 (如客户订单、生产计划和采购合同等) 从需方向供方流动时,便引发物流。
- 供应信息 (如入库单、完工报告单、库存记录、可供销售量和提货发运单等) 又同物料一起沿着供应链从供方向需方流动
- 参加电子商务的实体:客户、商户、银行及认证中心
- 电子数据交换 (EDI):
电子政务
- 电子政务的 4 种模式:政府对政府、政府对公务员、政府对企业、政府对公民
| 类型 | 典型场景 |
|---|---|
| G2G 政府对政府 | 人口信息共享、跨部门数据交换、上下级政府报送数据 |
| G2C 政府对公民 | 网上办身份证、社保查询、个税服务、政务信息公开 |
| G2B 政府对企业 | 政府向企业提供各种服务,如颁发营业执照、许可证等 |
| G2E 政府对公务员 |
企业应用集成 EAI
EAI(企业应用集成) 是一种通过系统架构和技术手段,实现企业内部多个系统间数据交换和协作的解决方案。
EAI 一般包括:表示集成(界面集成)、数据集成、控制集成、业务流程集成(过程集成)。
- 界面集成:把各应用系统的界面集成起来,统一入口。最浅层,属于黑盒集成。
- 数据集成:直接共享/交换数据库中的数据。需要了解数据结构,属于白盒集成。
- 控制集成:一个应用调用另一个应用的功能/API,又叫功能集成、应用集成,通常属于黑盒集成。
- 过程集成:为实现整体的业务目标定义、关联和管理不同的业务过程。
无需了解程序和数据库构造的,即为黑盒集成。
在数据集成方面,EAI 主要包括以下方式: 1. 数据复制:将数据从一个系统复制到另一个系统,适合于静态数据或更新频率较低的数据。 2. 基于接口的数据集成:通过定义系统间的数据接口,实现动态数据交换。不同应用系统间利用适配器来实现相互调用以达到集成的目标。 3. 数据联邦:通过联邦机制,使多个数据源看起来像一个虚拟数据库,适合实时性要求较高的场景。
EAI 提供 4 个层次的服务:通讯服务、信息传递与转化服务、应用连接服务、流程控制服务
企业网站发展
- 企业网站:这是最初级的阶段,主要注重消息的单向传送展示,缺乏信息互动。
- 企业信息门户(EIP):EIP 将企业的各种应用系统、数据资源和互联网资源统一集成,提供企业的产品和用户信息,实现信息共享。
- 企业应用门户(EAP):侧重于业务流程和企业应用的集成,而不是全面的信息资源集成。
- 企业知识门户(EKP):在企业网站基础上增加知识性内容,建立企业知识库,但不涉及应用系统和数据资源的全面集成。
诺兰模型
诺兰模型(Nolan Model)是用来描述一个组织的信息系统/信息化建设会如何逐步发展成熟的阶段模型。
| 阶段 | 名称 | 核心特点 |
|---|---|---|
| 1 | 初装阶段 | 刚开始引入计算机,少量部门试用 |
| 2 | 蔓延阶段 | 大家发现计算机好用,各部门纷纷上系统,快速扩张 |
| 3 | 控制阶段 | 系统太多、成本太高、重复建设,开始加强统一管理和控制 |
| 4 | 集成阶段 | 把原来各自独立的系统连接、整合起来,实现信息共享,预算费用迅速增长 |
| 5 | 数据管理阶段 | 从“管理系统”进一步转向“统一管理数据”,重视数据库和数据资源 |
| 6 | 成熟阶段 | 信息系统与组织业务、战略高度融合,信息化趋于成熟 |
新旧信息系统转换
| 转换方式 | 做法 | 风险 | 特点 |
|---|---|---|---|
| 并行转换 | 新旧系统同时运行一段时间 | 最低 | 最安全,但成本最高、工作量大 |
| 分段转换 | 按功能/阶段逐步替换旧系统 | 较低 | 一部分一部分地换 |
| 分块转换 | 按部门、地区等范围分批切换 | 较低 | 先在一小块范围使用,再推广 |
| 直接转换 | 某一天直接停旧系统、启用新系统 | 最高 | 快、便宜,但出问题没有退路 |
系统性能
- 在开始性能调整之前,必须做的准备工作有识别约束、指定负载、设置性能目标。
- MIPS = 1 / 一条指令执行时间 (微秒)
软件可靠性
- 软件可靠性是指在特定环境和特定时间内,计算机程序无故障运行的概率。
- 在软件可靠性的讨论中,故障指软件行为与需求的不符,故障有等级之分。
- 纠正一个故障可能会引入其他的错误,而这些错误会导致其他的故障。
- 软件可靠性能够通过历史数据和开发数据直接测量和估算出来。
计算机系统的可用性
计算机系统的可用性可从故障率(failure rate)、健壮性(robustness)和可恢复性(recoverability)三个方面来进行评测。
- 故障率是指在给定的时间里,系统故障和维护事件出现的次数。
- 健壮性是指系统检测和处理故障的能力,以及系统在各种故障情况下仍然具有的工作能力。
- 可恢复性是指系统从故障状态恢复到正常状态的能力。
RASIS 特性
| 字母 | 含义 | 简单理解 |
|---|---|---|
| R | 可靠性 | 系统尽量不出故障 |
| A | 可用性 | 出故障也要尽量保证能用 |
| S | 可维护性 | 出问题后能够快速修好 |
| I | 完整性 | 数据不能被错误、非法地篡改或破坏 |
| S | 安全性 | 防止未经授权的访问和攻击 |
评价指标
- 计算机:时钟频率 (主频)、运算速度、运算精度、内存的存储容量、存储器的存取周期、数据处理速率 (Processing Data Rate,PDR) 、吞吐率、各种响应时间、各种利用率、 RASIS 特性 (即可靠性 Reliability、可用性 Availability、可维护性、完整性和安全性、平均故障响应时间、兼容性、可扩充性和性能价格比)。
- PDR:值越大,机器性能越好;主要反映 CPU 和主存储器的速度;与每条指令、每个操作数的平均位数有关
- 数据库管理系统的主要性能指标包括数据库本身和管理系统两部分,即数据库的大小、数据库中表的数量、单个表的大小、表中允许的记录 (行) 数量、单个记录 (行) 的大 小、表中所允许的索引数量、数据库所允许的索引数量、最大并发事务处理能力、负载均衡能力及最大连接数等。
- 在 Web 服务器的测试中,反映其性能的指标主要有:最大并发连接数、响应延迟、连接速度和吞吐量等。常见的 Web 服务器性能评测方法有基准性能测试、压力测试和可靠性测试。
系统性能评价方法
| 方法 | 核心思想 | 怎么测 | 特点 |
|---|---|---|---|
| 指令执行速度法 | 看某一种典型指令跑多快 | 常用加法指令的执行速度衡量 | 简单,但代表性较差 |
| 等效指令速度法 | 不只看一种指令,而是把多种指令按比例加权 | 根据各类指令使用频率计算平均/等效执行速度 | 比单一指令更接近实际 |
| 综合理论性能法 | 根据硬件计算单元推算理论性能 | 分别计算各计算单元的有效计算率,再按字长修正,最后求和 | 算的是理论计算能力 |
| 基准程序法 | 直接让机器运行标准测试程序 | 比较运行时间、吞吐量或得分 | 更接近真实使用场景 |
阿姆达尔解决方案
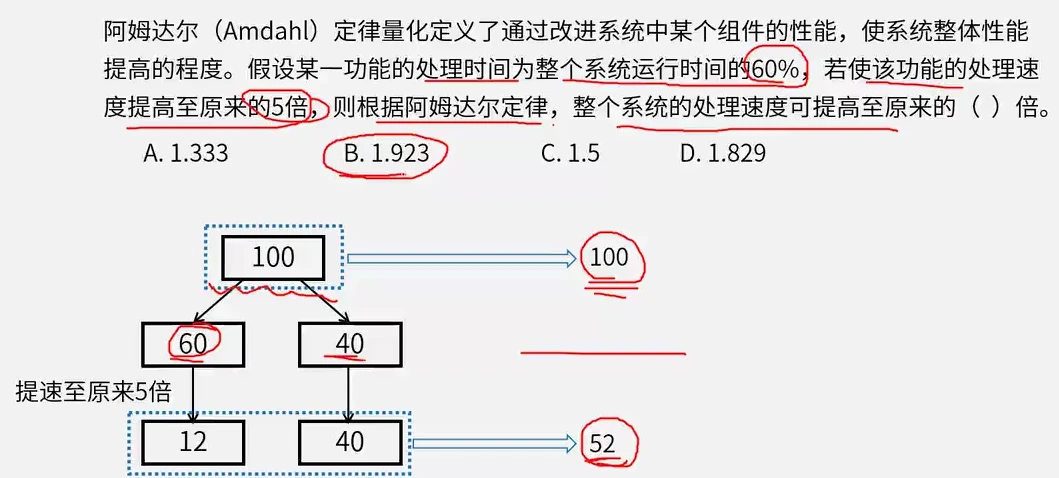
根据阿姆达尔定律,若某部件优化后加速比为 5,但其仅影响 30% 的任务执行时间,则系统总加速比约为 ( ) 。
加速比:原来/现在
假设原来整个程序运行 100 秒。其中 30% 的部分 30 秒,剩余 70 秒。 30 秒这部分加速 5 倍后:30/5=6 秒,优化后总时间=70+6=76,因此系统总加速比=100/76=1.32
性能指标计算方法
- 定义法获取理想数据
- 程序检测法受环境条件影响,结果可能差异较大
- 仪器检测法虽然较准确,但也可能受测试条件影响
- 公式法适用于计算复合性能指标
知识产权
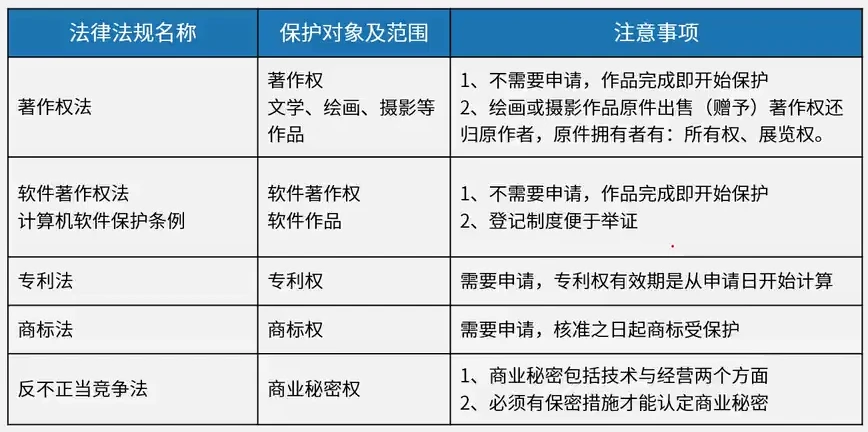
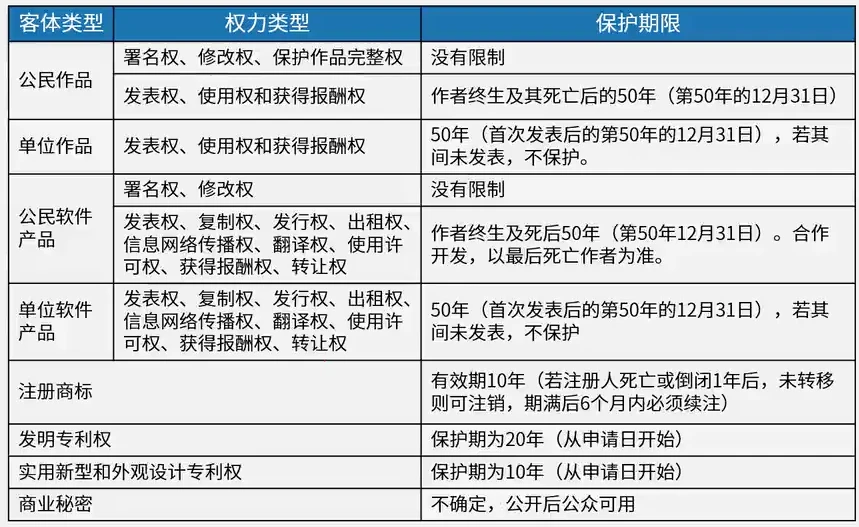
- 知识产权法属于民法
- 著作权法不适用于: 法律、法规,国家机关的决议、决定、命令和其他具有立法、行政、司法性质的文件,及其官方正式译文。
- 软件商标权保护的对象是软件注册商标(核准之日起受保护)
- 在发明或者实用新型专利申请文件中,权利要求书用于明确说明专利保护的范围,说明书则是用于详细描述发明的内容和实施方式。请求书和申请书都是提交专利申请时的必要文件,但并不是用于说明专利保护范围的主要部分。
- 一件外观设计专利申请中的相似外观设计不得超过 10 项。如果超过 10 项,审查员会发出审查意见通知书,申请人修改后未克服缺陷的,会驳回该专利申请。
- 关于美术作品原件所有权的转移不视作作品著作权的转移的规定适用于任何原件所有权可能转移的作品。原件持有人仅有所有权与展览权。
- 软件著作权人
- 可以许可他人行使其软件著作权,并有权获得报酬
- 软件著作权人可以全部或者部分转让其软件著作权,并有权获得报酬
- 为学习和研究软件内含设计思想和原理,通过安装等方式使用软件,可不经许可且不支付报酬
- 软件著作权属于自然人的,该自然人死亡后,在软件著作权的保护期内,继承人只能继承除署名权以外的其他权利
- 兼职开发的情况中,利用了兼职单位的物质技术条件,著作权应归属于提供物质技术条件的单位。
- 软件使用许可通常依据被许可方享有的排他性程度分为独占、排他、普通三类。独占使用许可中,著作权人自身也不能行使权利;排他使用许可下,著作权人保留自身使用权但不得再许可他人(许可方与被许可方共同使用);普通使用许可则允许著作权人自行使用并许可多个被许可人。
- 申请软件著作权登记应提交源程序和文档的鉴别材料。鉴别材料需包含程序的连续 30 页及文档的连续 30 页。
- 委托开发,在未约定的情况下,著作权归创作方。
- 甲完成软件的开发后就拥有了该软件的著作权,之后甲放弃该程序并决定重新开发,乙将该程序稍加修改就发布,侵犯了甲的软件著作权。
- 知识产权特性:
- 无形性,知识产权是一种没有形体的精神财富
- 地域性,知识产权具有严格的地域性特点
- 时间性,知识产权具有法定的保护期限
软件工程
- 能力成熟度模型(Capacity Maturity Model)软件开发机构中被广泛用来指导软件过程改进。
- 软件重用是指在两次或多次不同的软件开发过程中重复使用相同或相似软件元素的过程。软件元素包括程序代码、测试用例、设计文档、设计过程、需求分析文档甚至领域知识。
系统工程
-
系统工程利用现代电子计算机,对系统的结构、要素、信息和反馈等进行分析,以达到最优规划、最优设计、最优管理和最优控制等目的。
-
方法特点:整体性、综合性、协调性、科学性和实践性。
-
生命周期:
阶段 主要干什么 关键词 1. 探索性研究阶段 研究新技术、新需求、新机会,判断“有没有必要做、技术上有没有可能做” 技术探索、机会分析 2. 概念阶段 明确用户到底需要什么,提出系统的总体构想,分析可行性 用户需求、系统概念、可行性 3. 开发阶段 把比较粗的需求进一步细化,形成具体系统方案,并进行设计、实现、集成、测试 细化需求、解决方案、设计开发 4. 生产阶段 把已经开发验证好的系统正式生产、部署、交付 生产、部署、交付 5. 使用阶段 用户实际运行和使用系统,让系统发挥功能 运行、使用 6. 保障阶段 为系统持续运行提供维护、维修、升级、技术支持等 维护、保障、升级 7. 退役阶段 系统寿命结束,停止使用、迁移数据、拆除或处置 淘汰、下线、处置
切克兰德方法(Checkland)主要用来处理目标不清楚、参与者观点不一致、问题边界模糊的“软问题”,其核心思想是:先建立一个概念模型,再拿概念模型和现实世界进行比较,从差异中不断探寻可行的改进办法。
遗留系统
- 遗留系统的演化可以采用淘汰、继承、改造和集成四种策略。
- 淘汰策略(低技术、低价值):适用于技术含量较低,且具有较低的业务价值的遗留系统,即通过全面重新开发新的系统以代替(淘汰)遗留系统。
- 若遗留系统的技术含量较低,能满足企业运作的功能或性能要求,但具布较高的商业机制,目前企业的业务上紧密依赖该系统,这种遗留系统的演化策略为继承(低技术、高价值)。
- 对于技术含量较高,本身还有极大的生命力,又具有较高的业务价值,基本上能够满足企业业务运作和决策支持需要的遗留系统,采用**改造策略(高技术、高价值)**进行演化。
- 遗留系统的技术含量较高,但其业务价值较低,可能只完成某个部门(或子公司)的业务管理。这种系统在各自局部领域里工作良好,但对于整个企业来说,存在多个这样的系统,不同的系统基于不同的平台、不同的数据模型,形成了一个个信息孤岛。对于这种遗留系统的演化策略为集成(高技术、低价值)。
WSR 方法论
| 层面 | 核心问题 | 含义 | 例子 |
|---|---|---|---|
| 物理 Wuli | 是什么? | 客观存在的事实、规律、条件 | 设备、数据、资源、技术条件 |
| 事理 Shili | 怎么做? | 做事情的方法、流程、机制 | 方案设计、流程设计、技术路线 |
| 人理 Renli | 谁来做?如何协调? | 人的利益、关系、组织和协调 | 部门关系、人员分工、利益协调 |
- WSR 七个工作步骤:理解意图 → 制定目标 → 调查分析 → 构造策略 → 选择方案 → 协调关系 → 实现构想
- 不是流水线,可以反复、迭代、交叉进行
- 协调工作贯穿始终
MBSE
MBSE 是 Model-Based Systems Engineering,基于模型的系统工程。它的“三大支柱”通常概括为:建模语言 + 建模工具 + 建模思路(方法/方法论)。
| 支柱 | 解决什么问题 | 例子 |
|---|---|---|
| 建模语言 | 用什么规则表达模型 | SysML、UML |
| 建模工具 | 用什么软件画、管、分析模型 | Cameo、Rhapsody 等 |
| 建模思路 | 按照什么方法去建模 | 从需求到功能、逻辑、物理架构逐步建模 |
霍尔三维结构
霍尔把一个复杂系统工程问题放在三个维度上考虑:时间维 + 逻辑维 + 知识维,即:什么时候做 × 按什么步骤做 × 用什么专业知识做。
- 时间维:规划 → 拟定(方案) → 研制 → 生产 → 安装 → 运行 → 更新
工期问题
活动图
活动图,也叫 PERT 图,可以描述任务间的以来关系,但不能清晰描述各任务之间的并行情况。
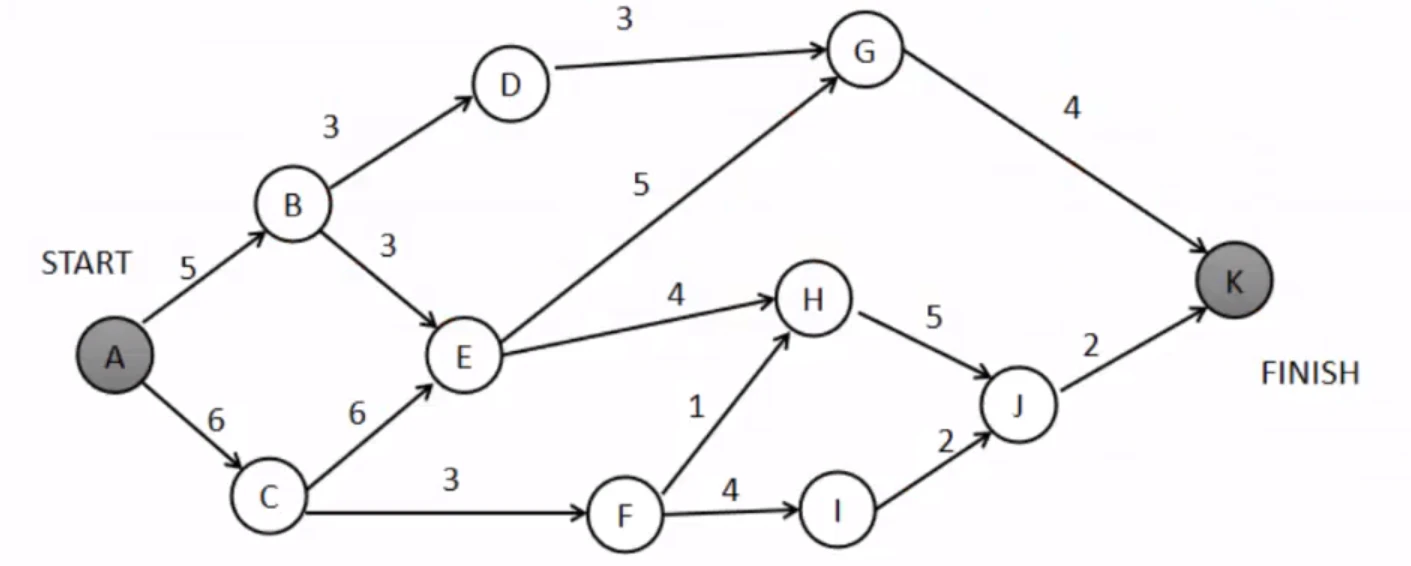
- 关键路径:开始节点到结束节点之间,持续时间最长的路径
ACEHJK,代表项目的最短完成时间。其长度就是把路径边值加起来的和23 - 里程碑:就是图里的节点
- 关键路径上的任何活动逾期,都会影响关键路径的长度 (项目的进度)
工期优化
某项目包括 A、B、C、D 四道工序,各道工序之间的衔接关系。正常进度下各工序所需的时间和直接费用、赶工进度下所需的时间和直接费用如下表所示。该项目每天需要的间接费用为 4.5 万元。根据此表,以最低成本完成该项目需要()天?
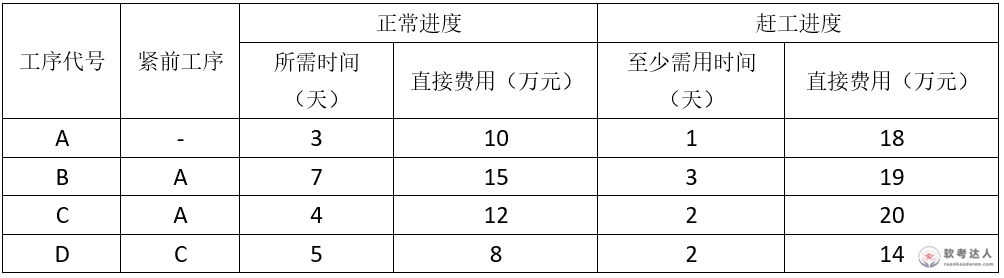
第一步,先画出网络关系:
┌── B起点 → A └── C → D带入时间可得 AB=10,ACD=12,因此关键路径为 ACD,对应工期为 12 天。
第二步,计算赶工费用率(费用斜率):(赶工费用-正常费用) / (正常时间-赶工时间),其含义为每压缩 1 天增加的费用。结果为:A 4 万/天,B 1 万/天,C 4 万/天,D 2 万/天。
由于每天的间接费用为 4.5 万/天,也就是说,只要压缩项目工期 1 天的成本低于 4.5 万,就值得压。
第三步,从关键路径开始压缩。由于 A、C、D 的费用斜率分别为 4、4、2,因此先压最便宜的 D。但需注意:压缩天数可能带来关键路径的变化,因此必须逐天尝试压缩!
- D 压 1 天 (5->4),费用斜率=2<4.5,AB=10,ACD=11,关键路径不变,因此继续压最便宜的 D。
- D 再压 1 天 (4->3),费用斜率=2<4.5,AB=10=ACD,关键路径变为 2 条。
- 同时压缩所有关键路径!此时有两种方案:压缩公共序列,或者分别压缩关键路径上的费用斜率最低序列。
- 若 A 压 1 天 (3->2),费用斜率=4<4.5,AB=9=ACD
- 若 D 压 1 天 (3->2),B 压 1 天 (7->6),费用斜率=1+2=3<4,此方案成本更低,因此 B、D 各压 1 天
- D 已经达到最大压缩天数,因此继续分别压缩两条关键路径:
- 若 A 再压 1 天 (3->2),费用斜率=4<4.5,AB=8=ACD
- 若 B 压 1 天 (6->5),C 压 1 天 (4->3),费用斜率=5>4.5,不划算。后续无需再计算该情况 。
- A 再压一天 (2->1),费用斜率=4<4.5,AB=7=ACD。
- 由于 AB 和 ACD 需同时压缩,而 A 已达到最大压缩天数,因此只能同时压缩 B 和 CD。其中,D 也已达最大压缩天数,压 BC 费用斜率大于 4.5,因此 7 天就是成本最低时的最短工期。
三点估算
某项目包括 A~G 七个作业,各作业之间的衔接关系和所需时间如下表:
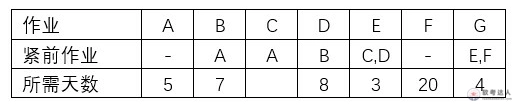 其中,作业 C 所需的时间,乐观估计为 5 天,最可能为 14 天,保守估计为 17 天。假设其他作业都按计划进度实施,为使该项目按进度计划如期全部完成。作业 C( )。
第一步,算期望时间。根据 PERT 三点估算公式:
其中:
- O:乐观时间 = 5 天
- M:最可能时间 = 14 天
- P:悲观时间 = 17 天
所以期望时间=13 天。
第二步,画网络关系:
B(7) → D(8) / \A(5) → E(3) → G(4) \ / | C(13) F(20) → G(4)第三步,找关键路径并计算路径时间差:
- ABD=5+7+8=20 天,AC=5+13=18 天
- 关键路径前序为 ABD 分支,意味着 C 比期望时间最多可拖延 2 天
JavaEE
JavaEE(J2EE)平台提供了对于不同类型遗产系统的集成支持。对于关系型数据库系统可以采用 JDBC(Java 数据库连接)进行连接,对于非 Java 应用系统可以采用 JCA(Java 连接器架构)连接,对于基于 COFJBA 的应用系统可以采用 Java lDL(Java 接口定义语言)实现集成。
EJB(Enterprise JavaBeans)是 Java EE 里的一个组件规范 / 企业级组件模型,分为会话 Bean、实体 Bean 和消息驱动 Bean:
- 会话 Bean(交互):用于实现业务逻辑,它可以是有状态的,也可以是无状态的。每当客户端请求时,容器就会选择一个会话 Bean 来为客户端服务。会话 Bean 可以直接访问数据库,但更多时候,它会通过实体 Bean 实现数据访问。
- 实体 Bean(数据库):用于实现 O/R 映射,负责将数据库中的表记录映射为内存中的实体对象,事实上,创建一个实体 Bean 对象相当于新建一条记录,删除一个实体 Bean 会同时从数据库中删除对应记录,修改一个实体 Bean 时,容器会自动将实体 Bean 的状态和数据库同步。
- 消息驱动 Bean(并发异步):EJB 3.0 中引入的新的企业 Bean,它基于 JMS 消息,只能接收客户端发送的 JMS 消息然后处理。MDB 实际上是一个异步的无状态会话 Bean,客户端调用 MDB 后无需等待,立刻返回,MDB 将异步处理客户请求。这适合于需要异步处理请求的场合,比如订单处理,这样就能避免客户端长时间的等待一个方法调用直到返回结果。
中间件
- 中间是指操作系统之上,应用软件之下,两者的中间
- 通信中间件实现跨平台数据传输
- 事务中间件处理并发事务
- Web 服务器中间件主要提供负载均衡、缓存、安全性等功能
- 安全中间件提供加密和认证功能
- 中间件的基本功能包括以下 6 个方面:
- 负责客户机与服务器之间的连接和通信,客户机与应用层之间的高效率通信机制。
- 提供应用层不同服务之间的互操作机制,应用层与数据库之间的连接和控制机制。
- 提供一个多层架构的应用开发和运行的平台,一个应用开发框架,支持模块化的应用开发。
- 屏蔽硬件、操作系统、网络和数据库的差异。
- 提供应用的负载均衡和高可用性、安全机制与管理功能,以及交易管理机制,保证交易的一致性。
- 提供一组通用的服务去执行不同的功能,避免重复的工作和使应用之间可以协作。
- 消息中间件:在两个应用程序之间,或分布式系统中发送消息,进行异步通信。
- 消息队列(Message queue 即 MQ)是在消息的传输过程中保存消息的容器。
- MQ 负责两个系统之间传递消息,这两个系统可以是异构的
- 消息中间件支持点对点模式、订阅发布模式、推拉模式。
- 分布式对象中间件:
- 由一组对象来提供系统服务,对象之间能够跨平台通信。
- 两种不同类型的支持:
- 交互支持:中间件协调系统中的不同组件之间的交互。
- 提供公共服务:中间件提供对服务的可复用的实现。这些服务可能会被分布式系统中的很多组件所需要。公共服务是指被不同组件需求的服务,不管这些组件的功能是什么。
软件构件
- 软件构件是部署、版本控制和替换的基本单位。构件是一组通常需要同时部署的原子构件。原子构件通常成组地部署,但是它也能够被单独部署。构件与原子构件的区别在于,大多数原子构件永远都不会被单独部署,尽管它们可以被单独部署。大多数原子构件都属于一个构件家族,一次部署往往涉及整个家族。一个模块是不带单独资源的原子构件。
- 面向构件的编程需要下列基本支持:多态性(可替代性)、模块封装性(高层次信息的隐藏)、后期的绑定和装载(部署独立性)和安全性(类型和模块安全性)。
- 构件组装是指构件相互直接集成或是用“胶水代码”将其整合在一起来创造一个系统或另一个构件的过程。常见的方式包括:顺序组装、层次组装、叠加组装。
- 构件组装中经常会面临接口不兼容的问题,如果一个构件的提供接口是另一个构件请求接口的一个子集,则属于操作不完备的情况。
- 构件是独立的软件单元,通常以二进制形式存在,无需在部署前编译,构件元数据是构件本身相关的数据。构件是可以配置的,以适应不同的应用系统需求。
- 接口是一个已命名的一组操作的集合。
- 软件构件的特性:
- 独立部署单元(自包容的程序集,可拆分)
- 没有外部可见状态(不能直接操作构件内部,必须通过接口访问)
- 第三方可组装单元(具有可重用性)
- 服务端构件模型的典型解决方案:EJB 模型(Sun 公司 J2EE 的一部分)和 COM+ 模型(微软公司)
- Web 服务器:servlet 模型(基于 Sun 公司 JSP 技术)和 Visual Basic 及其他微软的技术(基于微软公司 ASP 技术)
- 从构件的外部形态来看,构成一个系统的构件可分为 5 类:
- 独立而成熟的构件。独立而成熟的构件得到了实际运行环境的多次检验,该类构件隐藏了所有接口,用户只需用规定好的命令进行使用。例如,数据库管理系统和操作系统等。
- 有限制的构件。有限制的构件提供了接口,指出了使用的条件和前提,这种构件在装配时,会产生资源冲突、覆盖等影响,在使用时需要加以测试。例如,各种面向对象程序设计语言中的基础类库等。
- 适应性构件。适应性构件进行了包装或使用了接口技术,把不兼容性、资源冲突等进行了处理,可以直接使用。这种构件可以不加修改地使用在各种环境中。例如 ActiveX 等。
- 装配的构件。装配的构件在安装时,已经装配在操作系统、数据库管理系统或信息系统不同层次上,使用胶水代码就可以进行连接使用。目前一些软件商提供的大多数软件产品都属这一类。
- 可修改的构件。可修改的构件可以进行版本替换。如果对原构件修改错误、增加新功能,可以利用重新“包装”或写接口来实现构件的替换。这种构件在应用系统开发中使用得比较多。
架构失配
失配是指在软件复用的过程中,由于待复用构件对最终系统的体系结构和环境的假设与实际状况不同而导致的冲突。在构件组装阶段失配问题主要包括:
- 构件失配:系统对构件基础设施、构件控制模型和构件数据模型的假设存在冲突引起的失配
- 连接子失配:系统对构件交互协议、连接子数据模型的假设存在冲突引起的失配
CORBA
- CORBA 标准是一种早期非常经典的分布式对象中间件标准,是由 OMG(对象管理组织)制定的一种面向对象分布式应用程序体系规范。让不同机器、不同操作系统、甚至不同编程语言写出来的程序,能够像调用本地对象一样调用远程对象。主要分为三个层次:对象请求代理、公共对象服务和公共设施。
- 最底层是对象请求代理 ORB,规定了分布对象的定义(接口)和语言映射,实现对象间的通讯和互操作,是分布对象系统中的“软总线”;
- 在 ORB 之上定义了很多公共对象服务,可以提供诸如并发服务、名字、服务、事务(交易)服务、安全服务等各种各样的服务;
- 最上层的公共设施则定义了组件框架,提供可直接为业务对象使用的服务,规定业务对象有效协作所需的协定规则。
- 对象请求代理(Object Request Broker, ORB):负责客户端和服务器之间的远程调用通信,解释调用并负责查找实现该请求的对象,将参数传给找到的对象,并调用方法返回结果。客户方不需要了解服务对象的位置、通信方式、实现、激活或存储机制。
- 可移植对象适配器(Portable Object Adapter, POA):用于屏蔽 ORB 内核的实现细节,为服务器对象的实现者提供抽象接口,以便他们使用 ORB 内部的某些功能。
- 伺服对象(Servant):指具体程序设计语言的对象或实体,通常存在于一个服务程序进程之中。CORBA 对象的真正实现,负责完成客户端请求。
ORB 大致结构如下:
客户端 │ │ 调用远程对象 ▼ORB(对象请求代理) │ ▼POA(可移植对象适配器) │ ▼Servant(伺服对象) │ ▼真正执行方法构件分类方法
- 关键字分类法:是一种最简单的构件库组织方法,其基本思想是:根据领域分析的结果将应用领域的概念按照从抽象到具体的顺序逐次分解为树状或有向无回路图结构。每个概念用一个描述性的关键字表示。不可分解的原子级关键字包含隶属于它的某些构件。
- 刻面分类法:在刻面分类机制中,定义若干用于刻画构件特征的“面”(facet),每个面包含若干概念,这些概念表述构件在面上的特征。刻画可以描述构件执行的功能、被操作的数据、构件应用的语境或任意其他特征
- 超文本组织方法:超文本组织方法与基于数据库系统的构件库组织方法不同,它基于全文检索技术,主要思想是:所有构件必须辅以详尽的功能或行为说明文档;说明中出现的重要概念或构件以网状链接方式相互连接;检索者在阅读文档的过程中可按照人类的联系思维方式任意跳转到包含相关概念或构件的文档;全文检索系统将用户给出的关键字与说明文档中的文字进行匹配,实现构件的浏览式检索。
项目管理
- 项目范围是为了达到项目目标,为了交付具有某种特制的产品和服务,项目所规定要做的
- 产品范围是指信息系统产品或者服务所应该包含的功能,项目范围是指为了能够交付信息系统项目所必须做的工作。
- 产品范围是项目范围的基础,产品的范围定义是信息系统要求的度量
- 项目范围的定义是生产项目计划的基础。产品范围描述是项目范围说明书的重要组成部分。
- 项目范围说明书中,项目范围定义的输入包括:项目章程、项目范围管理计划、组织过程资产、批准的变更申请
- 项目时间管理中的过程包括:活动定义、活动排序、活动的资源估算、活动历时估算、制定进度计划以及进度控制。用工作分解结构(WBS)
- 在项目的成本管理中,成本预算将总的成本估算分配到各项活动和工作包上,来建立一个成本的基线。
- 在软件项目需求变更中,变更控制委员会负责决定哪些己建议需求变更或新产品特性付诸应用,决定在哪些版本中纠正哪些错误。广义上,变更控制委员会对项目中任何基线工作产品的变更都可以做出决定。
- 项目计划通常包含两个部分:
- 项目总计划包括范围计划、工作范围定义、活动定义、资源需求、资源计划、活动排序、费用估算、进度计划及费用计划
- 项目辅助计划包括质量计划、沟通计划、人力资源计划、风险计划、采购计划。
配置管理
- 在配置管理中,所有的配置项都应列入版本控制的范畴。配置项的状态通常有 3 种,分别是草稿、正式发布和正在修改。
- ISO9000(软件开发中管理质量相关的文档和配置项)、PMBOK(配置变更控制过程)、CMMI 都包含配置管理
软件生命周期模型
软件活动主要有:
- 软件描述。必须定义软件功能以及使用的限制。
- 软件开发。也就是软件的设计和实现,软件工程人员制作出能满足描述的软件。
- 软件有效性验证。软件必须经过严格的验证,以保证能够满足客户的需求。
- 软件进化。软件随着客户需求的变化不断地改进。
瀑布模型
- 瀑布模型将软件生命周期划分为需求分析、软件设计、程序编写、软件测试和运行维护等基本活动,并且规定了它们自上而下、相互衔接的固定次序,如同瀑布流水,逐级下落。
- 瀑布模型要求待开发的系统需求是完整的、简明的、一致的,其突出的缺点是不适应用户需求的变化,开发模型是线性的,用户只有等到整个过程的末期才能见到开发成果。对于需求不确定的软件产品不适合采用瀑布模型。
- 活动之间存在因果关系,前一阶段工作的结果是后一阶段工作的输入描述。
螺旋模型
- 强调风险问题。在快速(原型)模型的基础上扩展而成。实际上,它是生命周期模型与原型模型的结合。
- 四个主要活动:螺旋模型沿着螺线迭代,依次经历:计划制定、风险分析、工程实施、客户评估。
- UP/敏捷:增量与迭代
- V 模型:测试贯穿于始终
- 构建组装模型:模块化
软件开发方法
- 结构化法:自顶向下,逐步分解求精,模块化设计。应变能力差
- 面向对象方法:自底向上,符合思维习惯
- 面向服务方法:
- 粗粒度,松耦合
- 注重标准化,加强了系统的可复用性和可演化性
- 三个抽象级别:操作、服务和业务流程
- 原型法、渐进迭代式开发:针对需求不明确
- 原型化方法:先快速做出一个原型 → 给用户看 → 用户反馈 → 修改 → 再反馈 → 不断迭代完善
- 形式化方法:数学模型化,所有东西均可证明,而不是测试
- 精益开发是一个动态的、知识驱动的、以客户为中心的过程,通过这一过程使特定企业的所有人员以创造价值为目标不断地消除浪费。
敏捷方法
适应性的、以人为本、增量迭代、适合小型项目
- 极限编程 XP:
- 一种轻量级(敏捷)、高效、低风险、柔性、可预测的、科学的软件开发方式。
- 它由价值观、原则、实践和行为四个部分组成,彼此相互依赖、关联,并通过行为贯穿于整个生存周期。其四大价值观包括沟通、简单、反馈和勇气。
- 费用控制严格的公司使用
- 水晶方法:最少纪律约束仍能成功
- 开放式源码:开发人员地域分布广
- SCRUM:定义了可重复的方法过程
- 功用(特征)驱动开发方法(FDD):区分首席程序员和“类”程序员。整个项目按照一个个“小功能 Feature”推进。
- 自适应软件开发(Adaptive Software Development, ASD):猜测、合作与学习。需求变化大、环境不确定的项目,不试图一次性把计划全部定死,而是在开发过程中不断适应变化。
净室
净室 (Cleaning Room) 软件工程是一种应用数学与统计学理论以经济的方式生产高质量软件的工程技术,力图通过严格的工程化的软件过程达到开发中的零缺陷或接近零缺陷。净室方法不是先制作一个产品,再去消除缺陷,而是要求在规约和设计中消除错误,然后以“净”的方式制作,可以降低软件开发中的风险,以合理的成本开发出高质量的软件。
净室软件工程的理论基础主要是函数理论和抽样理论。
净室软件工程中应用的技术手段主要有以下 4 种:
- 统计过程控制下的增量式开发
- 基于函数的规范与设计
- 正确性验证(正确性验证被认为是 CSE 的核心,正是由于采用了这一技术,净室项目的软件质量才有了极大的提高。)
- 统计测试和软件认证
净室软件工程在使用的过程中,也显示出一些缺点:
- CSE 太理论化,需要更多的数学知识。其正确性验证的步骤比较困难且比较耗时。CSE 要求采用增量式开发、盒子结构、统计测试方法,普通工程师必须经过加强训练才能掌握,开发软件的成本比较高昂。
- 工程师可能对编程语言和开发环境还不熟悉,而且编译器或操作系统的 bug 也可能导致未预期的错误。
- CSE 毕竟脱胎于传统软件工程,不可避免地带有传统软件工程的一些弊端。
软件过程框架
- 统一过程(Rational Unified Process, RUP):用例驱动,以架构为中心,迭代和增量
- 初始:做什么
- 细化:系统架构
- 交付:产品提交给用户使用
- 构建:继续演进需求、架构、计划直到提交产品
- RUP 的每一轮迭代都要进行测试与集成
- RUP 的关键特性:用例驱动、以体系结构为中心、迭代式开发
软件可靠性
- N 版本设计
- 相异成分规范评审:确保不同工作组对需求规格说明书(SRS)的理解一致,排除误解或需求错误,同时禁止组间交流以保证独立性。
- 相异性确认:评估不同版本设计的独立性和差异性,确保每个版本使用不同的方法、工具和语言实现。
- 背对背测试:使用相同测试数据对多个版本进行测试,比较结果以发现潜在错误,提高可靠性。
逆向工程
- 实现级:抽象语法树、符号表、过程
- 结构级:程序分量之间相互依赖关系
- 功能级:程序段功能和程序段之间的关系
- 领域级:应用领域概念之间对应关系
需求工程
- 需求开发:需求获取、分析、定义和验证
- 需求管理:变更控制、版本控制、需求跟踪、需求状态跟踪
- 联合需求计划(JRP):通过高度组织的群体会议来分析企业内的问题并获取需求的过程。JRP 的主要意图是收集需求,而不是对需求进行分析和验证。实施 JRP 时应把握以下主要原则:在 JRP 实施之前,应制定详细的议程,并严格遵照议程进行;按照既定的时间安排进行;尽量完整地记录会议期间的内容;在讨论期间尽量避免使用专业术语;充分运用解决冲突的技能;会议期间应设置充分的间歇时间;鼓励团队取得一致意见;保证参加 JRP 的所有人员能够遵守实现约定的规则。
软件维护
- 预防性维护:在软件尚未发生问题时,为预防潜在问题而采取的措施。例如改进代码结构、增加注释、更新技术文档。目的是提高软件的长期可维护性和可靠性。
- 改正性维护:针对软件运行中发现的错误或缺陷进行修复的维护。目的是解决问题,使软件恢复正常运行。
- 完善(改善)性维护:为了满足用户对软件提出的新功能或性能需求而进行的修改或扩充。目的是增强软件功能、提高性能、改进用户体验。
- 适应性维护:为了适应外部环境的变化(如操作系统升级、硬件更换、法规变化等)而进行的软件调整。目的是确保软件能够继续在新环境中正常运行。
软件测试
软件测试可分为单元测试、集成测试、配置项测试、系统测试、验收测试和回归测试等类别。
- 单元测试也称为模块测试,测试的对象是可独立编译或汇编的程序模块、软件构件或面向对象软件中的类 (统称为模块),其目的是检查每个模块能否正确地实现设计说明中的功能、性能、接口和其他设计约束等条件,发现模块内可能存在的各种差错。单元测试的技术依据是软件详细设计说明书。
- 集成测试的目的是检查模块之间,以及模块和己集成的软件之间的接口关系,并验证已集成的软件是否符合设计要求。集成测试的技术依据是软件概要设计文档。
- 系统测试的对象是完整的、集成的计算机系统,系统测试的目的是在真实系统工作环境下,验证完整的软件配置项能否和系统正确连接,并满足系统/子系统设计文档和软件开发合同规定的要求。系统测试的技术依据是用户需求或开发合同。
- 配置项测试的对象是软件配置项,配置项测试的目的是检验软件配置项与软件需求规格说明的一致性。
- 确认测试主要验证软件的功能、性能和其他特性是否与用户需求一致。
- 验收测试是指针对软件需求规格说明,在交付前以用户为主进行的测试。
- 回归测试的目的是测试软件变更之后,变更部分的正确性和对变更需求的复合型,以及软件原有的、正确的功能、性能和其他规定的要求的不损害性。
灰盒测试除了重视输出相对于输入的正确性,也看重其内部的程序逻辑。
系统测试
- 系统测试是为了发现需求分析环节出现的错误。
- 系统测试的主要依据是软件需求规格说明书
白盒测试
- 流程图有 n 个判断节点,就需要 2n 个测试用例才能覆盖所有路径
当然,也可以手动数
- 各种覆盖方法中,语句覆盖是最弱的
- 测试原则:
- 程序模块中的所有独立路径至少执行一次
- 在所有的逻辑判断中,取“真”和取“假”的两种情况至少都能执行一次
- 每个循环都应在边界条件和一般条件下各执行一次
- 测试程序内部数据结构的有效性等
静态测试
静态测试是指被测试程序不在机器上运行,而采用人工检测和计算机辅助静态分析的手段对程序进行检测。静态测试包括对文档的静态测试和对代码的静态测试。
对代码的静态测试包括控制流分析、数据流分析、接口分析和表达式分析。
- 控制流分析。控制流分析是指使用控制流程图检査被测程序控制结构的过程。例如,可检查被测程序是否存在没有使用的语句或子程序、是否调用并不存在的子程序,以及是否存在无法达到的语句等。
- 数据流分析。数据流分析是指使用控制流程图分析数据各种异常情况的过程,包括数据初始化、賦值或引用过程中的异常。例如,引用未定义的变量、对以前未使用的变量再次陚值等程序差错或异常情况。
- 接口分析。接口分析主要包括模块之间接口的一致性分析、模块与外部数据库及其他软件配置项之间的一致性分析、子程序和函数之间的接口一致性分析等。例如可以检查函数形参与实现的数量、顺序、类型和使用的一致性。
- 表达式分析。表达式分析用于检查程序代码中的表达式错误。例如,括号不配对、数组引用越界、除数为零,以及浮点数变量比较时的误差等错误。
单元测试
单元测试也称为模块测试,测试的对象是可独立编译或汇编的程序模块、软件构件或面向对象软件中的类(统称为模块),其目的是检查每个模块能否正确地实现设计说明中的功能、性能、接口和其他设计约束等条件,发现模块内可能存在的各种差错。单元测试的技术依据是软件详细设计说明书。
测试一个模块时,可能需要为该模块编写一个驱动模块和若干个桩模块。驱动模块用来调用被测模块,它接收测试者提供的测试数据,并把这些数据传送给被测模块,然后从被测模块接收测试结果,并以某种可见的方式将测试结果返回给测试人员;桩模块用来模拟被测模块所调用的子模块,它接受被测模块的调用,检验调用参数,并以尽可能简单的操作模拟被调用的子程序模块功能,把结果送回被测模块。顶层模块测试时不需要驱动模块,底层模块测试时不要桩模块。
单元测试策略主要包括自顶向下的单元测试、自底向上的单元测试、孤立测试和综合测试策略。
- 自顶向下的单元测试先测试上层模块,再测试下层模块。测试下层模块时由于它的上层模块已测试过,所以不必另外编写驱动模块。
- 自底向上的单元测试。自底向上的单元测试先测试下层模块,再测试上层模块。测试上层模块由于它的下层模块己经测试过,所以不必另外编写桩模块。
- 孤立测试不需要考虑每个模块与其他模块之间的关系,逐一完成所有模块的测试。由于各模块之间不存在依赖性,单元测试可以并行进行,但因为需要为每个模块单独设计驱动模块和桩模块,增加了额外的测试成本。
- 综合测试。上述三种单元测试策略各有利弊,实际测试时可以根据软件特点和进度安排情况,将几种测试方法混合使用。
集成测试
- 软件集成测试也称为组装测试、联合测试(对于子系统而言,则称为部件测试)。它将已通过单元测试的模块集成在一起,主要测试模块之间的协作性。从组装策略而言,可以分为一次性组装测试和增量式组装(包括自顶向下、自底向上及混合式)两种。
- 集成测试计划通常是在软件概要设计阶段完成的
- 集成测试一般采用黑盒测试方法。
评价程序
- 应用程序中用的最多、最频繁的那部分核心程序作为评价计算机性能的标准程序,称为基准测试程序。
- 事务处理性能委员会 (TPC) 是制定商务应用基准程序(Benchmark) 标准规范、性能和价格度量,并管理测试结果发布的非营利组织,其发布的TPC-C 是在线事务处理的基准程序,TPC-D 是决策支持的基准程序。
| 类型 | 含义 | 对真实应用的代表性 |
|---|---|---|
| 真实程序 | 直接运行用户实际使用的软件/程序 | 最高 |
| 核心程序(Kernel) | 从真实程序中抽取最关键、最耗时的核心代码段 | 较高 |
| 小型基准程序 | 专门编写的较小测试程序,测试某些典型功能 | 一般 |
| 合成基准程序 | 根据统计得到的指令比例、操作频率等,“人工拼”出一个程序 | 最低 |
上述四类评价程序的准确度依次递减。
设计模式
- 创建型模式,共五种:工厂方法模式、抽象工厂模式、单例模式、建造者模式、原型模式。
- 结构型模式,共七种:适配器模式、装饰器模式、代理模式、外观模式、桥接模式、组合模式、享元模式。
- 行为型模式,共十一种:策略模式、模板方法模式、观察者模式、迭代子模式、责任链模式、命令模式、备忘录模式、状态模式、访问者模式、中介者模式、解释器模式。
责任链模式 Responsibility chain
使多个对象都有机会处理请求,从而避免请求的发送者和接收者之间的耦合关系。责任链模式将这些对象连成一条链,沿着该链传递请求,直到有一个对象处理它为止。
属于行为型对象模式。适用于:
- 有多个对象可以处理一个请求,具体由哪个处理,在运行时自动确定
- 想在不明确接收者的情况下,向多个对象中的某一个提交请求
- 可处理一个请求的对象集合应该被动态指定
中介者模式 Mediator
使用一个中介对象封装一系列的对象交互,使各对象不需要显示的相互引用,从而使其耦合松散,可以独立地改变它们之间的交互,类似于“电话接线员”。
属于行为型对象模式。适用于:
- 一组对象以定义良好但复杂的方式进行通信,产生的依赖关系结构混乱且难以理解
- 一个对象引用其他很多对象并且直接与这些对象通信,导致难以复用该对象
- 想定制一个分布在多个类中的行为,而又不想生成太多的子类
观察者模式 Observer
定义对象之间的一种一对多依赖关系,使得每当一个对象改变状态,则其相关依赖对象皆得到通知并被自动更新。
- 观察者(Observer)至少维护一个被观察对象(Subject)
- 一个被观察对象需要维护多个观察者
- 被观察对象需要通知观察者其自身的状态变化
策略模式 Strategy
针对一组算法,将每一个算法封装到具有共同接口的独立的类中,从而使得它们可以相互替换。策略模式使得算法可以在不影响到客户端的情况下发生变化。
外观模式 Fagade
要求外部与一个子系统的通信必须通过一个统一的外观对象进行,为子系统中的一组接口提供一个一致的界面,外观模式定义了一个高层接口,这个接口使得这一子系统更加容易使用。
装饰模式 Decorator
- 装饰模式就是把要添加的附加功能分别放在单独的类中,并让这个类包含它要装饰的对象,当需要执行时,客户端就可以有选择地、按顺序地使用装饰功能包装对象。可以给对象动态地添加一些额外的职责,而不改变该对象的结构。
- 可以再不修改对象外观和功能的情况下添加或考删除对象功能。在不使用静态继承的情况下,为修改对象功能提供了灵活的选择。
适配器模式 Adaptor
将一个类的接口转换成客户希望的另外一个接口。Adapter 模式使得原本由于接口不兼容而不能一起工作的那些类可以一起工作。
享元模式 Flyweight
通过运用共享技术,有效地支持大量细粒度的对象。系统只使用少量的对象,而这些对象都很相似,状态变化很小,对象使用次数增多。
访问者模式 Visitor
用于表示一个作用于某对象结构中的各元素的操作,它使得用户可以在不改变各元素的类的前提下,定义作用于这些元素的新操作。访问者模式使得新的操作变得很容易,但在一定程度上破坏了封装性。
桥接模式 Bridge
在以下情况可以使用 Bridge 模式:
- 不希望在抽象以及抽象的实现部分之间有一个固定的绑定关系。例如这种情况可能是因为,在程序运行时刻可以选择或切换实现部分;
- 类的抽象以及它的实现都应该可以通过生成子类的方法加以扩充,使用 Bridge 模式可以对不同的抽象接口和实现部分进行组合,并分别对它们进行扩充。
- 对一个抽象的实现部分的修改应该对用户不产生影响,即客户的代码不必重新编译。
Abstraction 定义抽象类的接口;维护一个指向 Implementor 类型对象的指针。RefinedAbstraction 扩充由 Abstraction 定义的接口。
设计原则
类的设计原则主要有七个,包括:开闭原则、里氏代换原则、迪米特原则(最少知道原则) 单一职责原则、接口分隔原则、依赖倒置原则、组合聚合复用原则。
- 共同重用原则是指一个包中的所有类应该是共同重用的。如果重用了包中的一个类,那么就要重用包中的所有类。
- 开放封闭原则,即软件实体(类、模块、函数等)应该是可以扩展的,即开放的。但是不可修改的,即封闭的。
- 接口分离原则,是指不应该强迫客户依赖于他们不用的方法,接口属于客户,不属于它所在的类层次结构。即依赖于抽象,不依赖于具体,同时,在抽象级别,不应该有对于细节的依赖。
- 共同封闭原则,是指包中的所有类对于同一类性质的变化应该是共同封闭的。一个变化若对包产生影响,则将对该包中的所有类产生影响,而对于其他的包不造成任何影响。
- 开闭原则:一个软件实体应当对扩展开放,对修改关闭。
- 里氏替换原则:子类型必须能够替换它们的基类型,即任何基类对象可以出现的地方,子类对象一定可以出现。
- 依赖倒转原则:要依赖于抽象,不要依赖于具体。
软件系统架构
软件架构设计包括提出架构模型、产生架构设计和进行设计评审等活动,是一个迭代的过程。架构设计主要关注软件组件的结构、属性和交互作用,并通过多种视图全面描述特定系统的架构。
软件系统架构是关于软件系统的结构、行为和属性的高级抽象。
- 在描述阶段,主要描述直接构成系统的抽象组件以及各个组件之间的连接规则,特别是相对细致地描述组件的交互关系。
- 在实现阶段,这些抽象组件被细化为实际的组件,比如具体类或者对象。软件系统架构不仅指定了软件系统的组织和拓扑结构,而且显示了系统需求和组件之间的对应关系,包括设计决策的基本方法和基本原理。
架构描述语言(Architecture Description Language,ADL) 是一种为明确说明软件系统的概念架构和对这些概念架构建模提供功能的语言。ADL 主要包括以下组成部分:组件、组件接口、连接件和架构配置。ADL 对连接件的重视成为区分 ADL 和其他建模语言的重要特征之一。
基于架构的开发 ABSD
- 基于软件架构的开发(Architecture Based Software Development,ABSD) 强调由商业、质量和功能需求的组合驱动软件架构设计。
- 它强调采用视角和视图来描述软件架构,采用用例和质量属性场景来描述需求。
- ABSD 体系结构需求来自系统的质量目标、系统的商业目标,系统开发人员的商业目标三个方面(一质量二商业三系统)
- 质量目标(如性能、可靠性、可扩展性等)
- 商业目标决定了系统开发的总体方向和优先级,如降低成本、缩短上市时间、增加市场竞争力等。
- 开发人员的目标可能包括技术可行性、开发效率、代码可复用性等,与商业目标和质量目标密切相关。
- ABSD 方法有三个基础。第一个基础是功能的分解,使用已有的基于模块的内聚和耦合技术;第二个基础是通过选择架构风格来实现质量和业务需求;第三个基础是软件模板的使用,软件模板利用了一些软件系统的结构。
4+1 视图
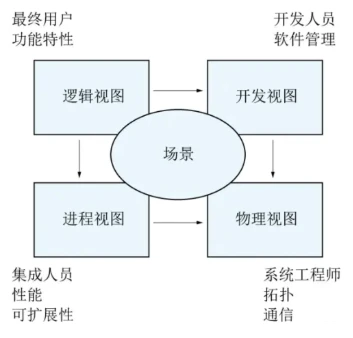
架构风格
| 架构风格 | 考点 |
|---|---|
| 批处理 | 分批处理,顺序执行 |
| (管道)过滤器 | 过滤器可以并行 |
| 黑板 | 知识为中心,求解麻烦 |
| 架构风格 | 核心思想 | 人话理解 | 典型例子 |
|---|---|---|---|
| 层次型 | 系统划成若干层,上层使用下层服务 | 一层压一层 | OSI、TCP/IP、物联网 |
| 事件系统 | 某组件产生事件,其他组件监听并响应 | 有事喊一声,谁关心谁处理 | GUI、消息通知、事件总线 |
| 数据流 | 数据依次经过若干处理步骤 | 流水线加工数据 | 编译器、Unix Pipe |
| C2 | 组件通过连接器异步传递消息,彼此尽量解耦 | 组件不直接找对方,通过中间人发消息 | GUI/交互软件架构 |
- 软件架构风格是描述某一特定应用领域中系统组织方式的惯用模式。架构风格定义了一类架构所共有的特征,主要包括架构定义、架构词汇表和架构约束。
- 软件架构风格描述某一特定领域中的系统组织方式和惯用模式,反映了领域中众多系统所共有的结构和语义两个方面的特征。
- 体系结构演化 6 个步骤:需求变化归类;制订体系结构演化计划;构件变动;更新构件的相互作用;构件组装与测试;技术评审;演化后的体系结构。
- 对于语音识别、知识推理等问题复杂、解空间很大、求解过程不确定的这一类软件系统,通常会采用黑板架构风格,以知识为中心进行分析与推理。
- C2 体系结构风格可以概括为:通过连接件绑定在一起的按照一组规则运作的并行构件网络。C2 风格中的系统组织规则如下:
- 系统中的构件和连接件都有一个顶部和一个底部
- 构件的顶部应连接到某连接件的底部,构件的底部则应连接到某连接件的顶部,而构件与构件之间的直接连接是不允许的
- 一个连接件可以和任意数目的其他构件和连接件连接
- 当两个连接件进行直接连接时,必须由其中一个的底部到另一个的顶部
- 进程通信风格是一种重要的架构风格,专注于多个独立进程之间如何进行通信。其连接件用于在进程之间传递数据和协调操作。
- 消息传递是进程通信风格的典型连接件。提供了进程间通信的机制,允许一个进程将消息发送到另一个进程。具体的实现方式可以包括消息队列、管道、共享内存等。
- 消息队列(Message Queue)是一种实现消息传递的技术,提供了一个缓冲区,允许发送和接收消息。属于消息传递机制的实现方式,但它本身不是通信风格的连接件。
微服务
微服务是一种架构风格,将单体应用划分成一组小的服务,服务之间相互协作,实现业务功能每个服务运行在独立的进程中,服务间采用轻量级的通信机制协作 (通常是 HTTP/JSON),每个服务围绕业务能力进行构建,并且能够通过自动化机制独立地部署。
微服务优势:
- 通过分解巨大单体式应用为多个服务方法解决了复杂性问题。它把庞大的单一模块应用分解为一系列的服务,同时保持总体功能不变,但整体并发却得到极大提升。
- 让每个服务能够独立开发,开发者能够自由选择可行的技术,提供 API 服务。
- 微服务架构模式是每个微服务独立的部署。开发者不再需要协调其他服务部署对本服务的影响。这种改变可以加快部署速度。
- 微服务使得每个服务独立扩展。你可以根据每个服务的规模来部署满足需求的规模。甚至可以使用更适合于服务资源需求的硬件。
缺点/挑战:
- 并非所有的系统都能转成微服务。
- 部署较单体架构更加复杂(容器技术能够解决这一问题)
- 性能问题:由于微服务注重独立性,互相通信时只能通过标准接口,可能产生延迟或调用出错。
- 数据一致性问题:作为分布式部署的微服务,在保持数据一致性方面需要比传统架构更加困难。
分层架构
- 分层架构是低耦合的,依赖关系非常简单,上层只能依赖于下层,没有循环依赖。底层错误将导致整个系统无法运行。
- 脆弱性是客观存在的,但它本身没有实际伤害
面向服务 SOA
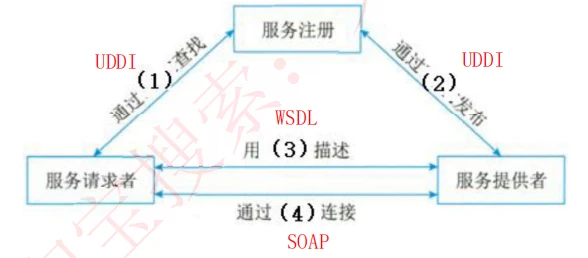
- 服务提供者、服务使用者和服务注册器之间的远程交互通过SOAP(简单对象访问协议)消息实现。
- 服务内容描述通过WSDL(Web 服务描述语言)标准实现
- 服务注册信息通过UDDI(服务统一描述、发现和集成)框架实现
- 通过BPEL/BPEL4WS(业务过程执行语言)将分散的、功能单一的 Web 服务组织成一个复杂的有机应用。
- SOAP 是一种通信协议,主要用于在分布式环境中通过网络交换结构化信息。封装,定义了一个描述消息中的内容是什么,是谁发送的,谁应当接收并处理它以及如何处理它们的框架
- SOAP RPC 表示是远程过程调用和应答的协定
- WSDL 提供“提供什么服务,如何使用,谁可以使用/服务做什么、如何访问服务和服务位于何处”的信息
- 服务组件体系结构 (SCA) 是面向服务体系结构 (SOA) 中描述服务之间组合和协作的规范。
- SCA 定义了语言中立的服务组合方式,能够进行跨语言的服务调用;
- SCA 解决的主要问题是加强组件的接口与传输协议的关联,降低组件之间的耦合度;
- SCA 实现服务组件和其传输协议的绑定,这种绑定是可扩展的;
- SCA 主要是为了满足软件集成的需要而创建的架构
特定领域软件架构 DSSA
- 特定领域软件架构(Domain Specific Software Architecture,DSSA) 是在一个特定应用领域中,为一组应用提供组织结构参考的标准软件体系结构。DSSA 通常是一个具有三个层次的系统模型,包括领域开发环境、领域特定应用开发环境和应用执行环境,其中应用工程师主要在领域特定应用开发环境中工作。
- 特定领域软件架构(Domain Specific Software Architecture,DSSA) 以一个特定问题领域为对象,形成由领域参考模型、参考需求、参考架构等组成的开发基础架构,其 n 标是支持一个特定领域中多个应用的生成。
- DSSA 的基本活动包括领域分析、领域设计和领域实现。其
- 领域分析的主要目的是获得领域模型,领域模型描述领域中系统之间共同的需求,即领域需求;
- 领域设计的主要目标是获得 DSSA,DSSA 描述领域模型中表示需求的解决方案(特定领域软件架构);
- 领域实现的主要目标是依据领域模型和 DSSA 开发和组织可重用信息,并对基础软件架构进行实现。
- 参加 DSSA 的人员可以划分为 4 种角色
- 领域分析者的任务是控制整个领域分析过程,进行知识获取,将获取的知识组织到领域模型中;
- 领域设计者的任务是根据领域模型和现有系统开发出 DSSA,并对 DSSA 的准确性和一致性进行验证。
- 领域专家
- 领域实现人员
- DSSA 的建立过程并不是线性顺序的,而是强调并发、递归和反复迭代,因为不同阶段(如领域分析、体系结构设计、验证等)通常需要交替进行,反复优化以适应领域需求。
- 定义领域特定元素的阶段重点是确定领域的通用功能和特定需求
- 定义领域模型和体系结构的阶段目标是抽象出领域内通用的模型和体系结构
智能制造系统架构
| 层级 | 干什么 | 你可以这样理解 |
|---|---|---|
| 设备层 | 直接执行、感知和操控物理生产过程 | 机器干活 |
| 单元层 | 企业内部处理信息,监测和控制物理流程 | 控制机器 |
| 车间层 | 面向工厂/车间进行生产管理 | 管生产 |
| 企业层 | 面向整个企业进行经营管理 | 管企业 |
| 协同层 | 企业内外信息互联共享,进行跨企业业务协同 | 企业之间合作 |
生命周期:设计 → 生产 → 物流 → 销售 → 服务
架构评估
- CBAM 协助相关方根据投资回报率(ROI)来选择最优架构策略。
体系结构权衡分析方法 ATAM
- 架构权衡分析方法是一种系统架构评估方法,主要在系统开发之前,针对性能、可用性(实用性)、安全性、可修改性和可靠性等质量属性进行评价和折中。
- 该框架主要关注系统的需求说明。
- ATAM 可以分为4 个主要的活动阶段,包括场景和需求收集、架构视图和场景实现、属性模型构造和分析、架构决策(属性模型)折中,整个评估过程强调以属性作为架构评估的核心概念。ATAM 方法要求在系统开发之前,首先对这些质量属性进行评价和折中。
- 属性实现的常用架构策略
- 可用性:心跳、Ping/Echo、主动冗余、被动冗余、选举
- 性能:增加计算资源、减少计算开销、引入并发机制、采用资源调度
- 安全性:入侵检测、用户认证、用户授权、追踪审计
- ATAM 头脑风暴的三种场景是:
- 用例场景:系统在典型工作负载或使用情况下的行为
- 增长场景:统随着需求变化或规模扩展的能力
- 探索性场景:非典型或异常使用情况下的表现,强调鲁棒性和边界条件
- 效用树:树根 — 质量属性 — 属性分类 — 质量属性场景 (叶子节点)
| 质量属性 | 含义 | 典型衡量指标 |
|---|---|---|
| 1. 性能(Performance) | 系统运行得快不快 | 响应时间、吞吐量、并发数 |
| 2. 可用性(Availability) | 系统能不能持续提供服务 | 可用率、故障恢复时间 |
| 3. 易用性(Usability) | 用户使用起来方不方便 | 学习时间、操作步骤、错误率 |
| 4. 安全性(Security) | 能不能防止非法访问、攻击和数据泄露 | 攻击检测时间、未授权访问阻止率 |
| 5. 可修改性(Modifiability) | 需求变化后,系统容不容易修改 | 修改所需时间、成本、影响范围 |
| 6. 可测试性(Testability) | 能不能方便地测试和验证系统 | 测试执行时间、故障定位时间、测试覆盖率 |
除了上述 6 个,还经常出现:
| 质量属性 | 含义 |
|---|---|
| 可靠性(Reliability) | 系统在规定条件和时间内无故障运行的能力 |
| 可维护性(Maintainability) | 系统出现问题后,便于分析、修复和维护 |
| 可扩展性(Extensibility) | 容易增加新功能或扩展已有功能 |
| 可伸缩性(Scalability) | 能通过增加资源支持更多用户或更大负载 |
| 可移植性(Portability) | 能够迁移到不同操作系统、硬件或运行环境 |
| 互操作性(Interoperability) | 能够与其他系统交换信息并协同工作 |
| 可重用性(Reusability) | 构件、模块能被其他系统重复使用 |
| 可恢复性(Recoverability) | 故障发生后恢复系统状态和数据的能力 |
基于场景的架构分析方法 SAAM
- SAAM 的目标是通过场景验证架构假设和原则,评估架构固有风险,比较不同架构方案
- SAAM 采用场景技术进行评估,将质量属性具体化为场景描述。
- SAAM 关注的主要质量属性是可修改性,但也可扩展到其他属性。
- SAAM 协调不同利益相关者的关注点,达成架构共识。
- SAAM 针对最终架构而非详细设计进行评估
- SAAM 的评估过程包括:场景开发、架构描述、单场景评估、场景交互评估和总体评估
质量属性场景
质量属性场景是一种面向特定质量属性的需求,由 6 部分(6 元素)组成:
- 刺激源:某个生成该刺激的实体(人,计算机,其它任何刺激器);
- 刺激:指当刺激达到系统时需要考虑的条件;
- 环境:指该刺激在某些条件哪发生;
- 制品:某个制品被激励,可能是整个系统,也可能是系统的一部分;
- 响应:指在激励达到后所采取的行动;
- 响应度量:当响应发生时,应当能够以某种方式对其进行度量。
例如:正常负载情况下,系统必须在 0.1 秒内对用户的交易请求进行响应
- 刺激源:用户
- 刺激:交易请求
- 环境:运行时(如果没有可以任意写)
- 制品:系统
- 响应:处理用户交易请求
- 响应度量:0.1 秒
嵌入式
- 嵌入式系统的特性:
- 面向应用,可以进行检查和移植,以支持开放性和可伸缩性的体系结构;
- 强实时性,以适应各种控制设备及系统;
- 硬件适用性,对于不同硬件平台提供有效的支持并实现统一的设备驱动接高可靠性,运行时无须用户过多干预,并处理各类事件和故障;
- 编码体积小,通常会固化在嵌入式系统有限的存储单元中。
- 嵌入式系统处理器:
- 嵌入式微处理器(MPU) 是嵌入式系统硬件层的核心,大多工作在为特定用户群专用设计的系统中,它将通用 CPU 中许多由板卡完成的任务集成在芯片内部,从而有利于嵌入式系统在设计时趋于小型化,同时还具有很高的效率和可靠性。
- 嵌入式微控制器(Embedded Microcontroller Unit,EMCU)的典型代表是单片机。它体积小,结构紧凑,作为一个部件安装在所控制的装置中,主要执行信号控制的功能。
- 数字信号处理器(digital signal processor,DSP)由大规模或超大规模集成电路芯片组成,是用来完成某种信号处理任务的处理器。它是为适应高速实时信号处理任务的需要而逐渐发展起来的。随着集成电路技术和数字信号处理算法的发展,数字信号处理器的实现方法也在不断变化,处理能力不断提高。
- 片上系统(System-on-a-chip,SOC)指的是在单个芯片上集成一个完整的系统,一般包括中央处理器(CPU)、存储器,以及外围电路等。SOC 是与其他技术并行发展的,如绝缘硅(SOI),它可以提供增强的时钟频率,从而降低微芯片的功耗。
- 较典型的嵌入式软件架构有两种:层次化模式架构和递归模式架构。
- 嵌入式系统分为三层:应用软件、操作系统软件和中间件
- 中间件的主要作用是屏蔽底层操作系统和硬件的差异
- 嵌入式软件质量特性:
- 可裁剪性:可以根据具体硬件和应用需求,删减不需要的功能和模块
- 可靠性:在规定条件、规定时间内持续正确工作的能力
- 安全性:即使发生异常,也尽量不造成危险、人员伤害或重大损失
- 高确定性:软件的行为是预先定义、可预测的,不应因为非设计因素随时间或状态任意变化
DO-178B 标准
DO-178B 是航空领域非常重要的一套机载软件开发与适航认证标准,它主要解决的问题是:飞机上的软件应该按照什么过程开发、验证、配置管理和质量保证,才能证明它足够可信,可以用于航空器适航认证。
DO-178B 最经典的考点是把机载软件按失效后果分为 A~E 五个等级:
| 等级 | 失效后果 | 严格程度 |
|---|---|---|
| A | 灾难性 Catastrophic | 最高 |
| B | 危险/严重 Hazardous | 很高 |
| C | 重大 Major | 较高 |
| D | 轻微 Minor | 较低 |
| E | 无安全影响 No Effect | 最低 |
比如:
- 飞控核心软件出错可能导致坠机,通常属于 A 级;
- 娱乐系统软件出错基本不影响飞行安全,可能属于 E 级。
信息安全
- OSI 定义了 7 层协议,其中除物理层外,每一层均能提供相应的安全服务。
- 目前数据库管理系统提供的基本数据加密方式主要包括加解密 API和透明加密两种
- 加解密 API:数据库管理系统提供可在 SQL 语句中调用的加解密 API,应用可以利用这些 API 构建自己的基础架构,对数据进行加密保护。
- 透明加密:安全管理员为数据库敏感字段选择加密方式及密钥强度,应用访问受保护数据时只需使用口令打开或关闭密钥表,对数据的加密和解密由数据库管理系统自动完成。
- 加解密 API 方式的灵活性强,但构建和管理复杂;而透明加密方式管理简单,应用程序负担轻,但灵活性较差。
- SQL 注入是一种常见的安全攻击手段,攻击者通过将恶意的 SQL 代码插入到输入字段或 URL 参数中,试图篡改查询逻辑,从而获取、修改或破坏数据库中的数据。
- 使用预编译查询或参数化查询是防范 SQL 注入的有效措施(将 SQL 语句和参数分离)
- ORM(对象关系映射)工具通常会自动对查询进行参数化处理,从而减少 SQL 注入的风险
- 攻击者可以通过 SQL 注入插入 UNION 查询,将额外的敏感信息合并到返回结果中
- 信息安全审计四要素:
- 控制目标:企业根据实际情况制定的安全控制要求。
- 安全漏洞:系统易被干扰或破坏的薄弱环节。
- 控制措施:为实现安全目标制定的技术、配置方法和管理制度。
- 控制测试:验证控制措施的存在、执行情况及对漏洞的防范效果,评估其可靠性
- 数据分级分类涉及的安全层级
- 基础安全层:这是数据安全管理的基础层,涵盖数据分级分类、数据备份、数据加密等基本安全措施。
- 权限控制层:主要负责数据的访问权限管理,确保只有授权用户可以访问特定数据。
- 战略安全层和应用接口层:更多地用于高层安全策略或接口相关管理,但与数据分级分类关系较弱。
- 安全监控系统、审计系统和日志管理系统共同构成了完整的系统安全监控体系。
- 网络攻击分为被动攻击与主动攻击,核心区别在于是否篡改或破坏数据。被动攻击通过非侵入方式秘密获取信息,典型形式为网络监听(如截获通信内容),不直接影响系统运行;主动攻击则包含拒绝服务、重放、假冒等主动干扰或伪造数据的行为。
- 数据库安全明确分为数据库管理系统安全和数据库应用系统安全两个部分。
- IETF 集成服务(IntServ) 工作组根据服务质量的不同,把 Internet 服务分成了三种类型:
- 保证质量的服务(Guranteed Services):对带宽、时延、抖动和丢包率提供定量的保证;
- 负载受控的服务(Comrolled-load Services):提供一种类似于网络欠载情况下的服务,这是一种定性的指标;
- 尽力而为的服务(Best-Effort):这是 Internet 提供的一般服务,基本上无任何质量保证。
- 秘密 10 年,机密 20 年,绝密 30 年(一般不超过,特殊可除外)
信息系统安全框架
- 信息系统安全框架的技术体系包括五个主要方面:基础安全设备、计算机网络安全、操作系统安全、数据库安全和终端设备安全。
- 信息安全系统框架由技术体系、组织机构体系和管理体系共同构建
- 管理体系:法律管理、制度管理和培训管理
- 根据信息安全系统框架的技术体系划分,密码芯片和加密卡属于基础安全设备的范畴。
- 完整的信息安全系统至少包含三类措施:技术方面的安全措施,管理方面的安全措施和相应的政策法律。
- 信息安全技术涉及信息传输的安全、信息存储的安全以及对网络传输信息内容的审计三方面,当然也包括对用户的鉴别和授权。
- 信息安全的技术措施主要有:信息加密、数字签名、身份鉴别、访问控制、网络控制技术、反病毒技术、数据备份和灾难恢复。
- 实现安全管理,应有专门的安全管理机构;有专门的安全管理人员;有逐步完善的管理制度;有逐步提供的安全技术设施。
- 信息安全管理主要涉及以下几个方面:人事管理;设备管理;场地管理;存储媒体管理;软件管理;网络管理;密码和密钥管理。
加密算法
- 文件数据量较大,使用流加密方式可以获得更高的加解密效率
- 先做数据摘要,再加密,同时保证数据机密性和完整性
- DES 加密分组长度 64 位,密钥长度 56 位;3DES 用到 2 个 DES 的密钥,因此密钥长度为 112 位
- RSA 算法的安全性基于大素数分解的困难性
- 分组密码是在明文分组和密文分组上进行运算,将明文按固定长度分组后逐组加密;序列密码是对明文和密文数据流按位或字节进行运算,逐位或逐字节地加密数据流。
| 对比项 | 对称加密 | 非对称加密 |
|---|---|---|
| 密钥 | 加密、解密用同一把密钥(或可以相互推导) | 使用一对密钥:公钥 + 私钥 |
| 速度 | 快 | 慢 |
| 加密强度 | 不高 | 高 |
| 适合处理 | 大量数据 | 少量数据、密钥交换、数字签名 |
| 密钥分发 | 比较麻烦,密钥必须安全传给对方 | 公钥可以公开,私钥自己保存 |
| 常见算法 | AES、DES、3DES、SM4、RC-5、IDEA | RSA、ECC、ElGamal、SM2 |
| 主要问题 | 密钥如何安全地交给对方 | 运算复杂、性能较低 |
消息摘要算法
MD5:
- MD5 可以将任意长度的数据映射为 128 位哈希值,且是不可逆的。
- MD5 存在碰撞漏洞,不同输入可能会生成相同的哈希值。哈希算法本质上无法解密,因为它是单向的。
- MD5 算法可以用来校验数据的完整性
- 从广义上,有时将单向哈希视为加密的一种形式,尽管它并不能解密。
密钥管理技术
- 对称密钥分配系统中,需要解决的两个核心问题是:引进自动分配密钥机制提高系统效率,尽可能减少系统中驻留密钥量
- 对称密钥管理的控制矢量技术中,会话密钥的加密过程是:先对控制矢量做杂凑,再与主密钥异或,得到一个“变形后的主密钥”,再用它去加密会话密钥。
- 密钥的选择和生成主要考虑三个因素:增大密钥空间、选择强钥和密钥的随机性
- 密钥标签技术将 DES 中的 8 个校验位作为控制密钥的标签,前 3 位分别代表主/会话密钥、加密、解密等不同信息
- 公钥证书的数据项内容:用户身份、时间戳、密钥版本
| 名称 | 属于哪类 | 作用 | 理解 |
|---|---|---|---|
| 密钥标签 | 对称密钥管理 | 给密钥附加一个固定格式的标识/用途说明 | “给密钥贴标签” |
| 控制矢量 | 对称密钥管理 | 描述密钥用途,而且长度可变,可参与密钥派生/保护 | “功能更强的密钥权限说明” |
| 公开发布 | 公钥管理 | 用户直接把自己的公钥公开出去 | “我自己宣布这是我的公钥” |
| 公用目录表 | 公钥管理 | 由一个目录集中保存“用户身份—公钥”对应关系 | “公钥电话簿” |
| 公钥管理机构 | 公钥管理 | 由可信第三方在线提供/确认公钥 | “找权威机构现场查询公钥” |
| 公钥证书 | 公钥管理 | CA 用数字签名把“身份”和“公钥”绑定起来,避免由统一机构管理带来的不便和安全隐患 | “带官方盖章的公钥身份证” |
访问控制
基于任务的访问控制(TBAC)模型的组成要素包括工作流、授权结构体、受托人集和许可集。
- 工作流定义了任务的流程
- 授权结构体定义了访问控制规则
- 受托人集是被授权执行任务的用户或实体
- 许可集则是具体的权限集合。
访问控制的基本模型包含三个核心要素:
-
主体 Subject:发起访问、执行操作的一方。例如用户、进程、服务、应用程序。
-
客体 Object:被访问、被操作的资源。例如文件、数据库、目录、设备、网络资源。
-
访问控制策略/规则:规定“主体能对客体做什么,以及在什么条件下可以做”。比如某用户对某文件具有读、写、执行权限。
-
授权关系表中每一行表示主体和客体的一个授权关系,对应访问矩阵中每一个非空元素的实现技术,适合采用关系数据库来实现。
-
可用的数字签名应保证五个条件:可信、不可伪造、不可重用、不可改变和不可抵赖。
-
访问控制矩阵:以主体为行索引,以客体为列索引,矩阵元素表示访问方式集合
-
能力表:访问控制矩阵的一行,以主体为索引,记录该主体对所有客体的访问权限
-
访问控制表:访问控制矩阵的一列,按列保存访问矩阵,每个客体对应一个表
Kerberos
Kerberos 是一种网络身份认证系统/认证协议。它的核心作用是:在不直接传输用户密码的情况下,让客户端和服务器相互确认“你是谁”。
用户登录后,Kerberos 不会让你每访问一次服务器都重新输入密码,而是由一个可信的认证中心给你发“票据(Ticket)”,之后你拿票据去访问其他服务。
Kerberos 里常见三个角色:
- 客户端 Client:用户或程序,代表用户去申请认证、拿票据、再拿票据访问具体服务。
- 认证服务器 AS:负责第一次确认“你是谁”。用户登录后,AS 验证用户身份,成功后发给用户一个 TGT(票据授权票据)。
- 票据授权服务器 TGS:负责根据 TGT 再发具体服务的票据。比如你要访问文件服务器,就拿 TGT 去找 TGS,TGS 给你一个“文件服务器访问票据”。
- 应用服务器 Server:真正提供服务的服务器,比如文件服务器、数据库服务器、邮件服务器。它检查你带来的服务票据,确认无误后才允许访问。
Kerberos 里经常把 AS + TGS 合起来叫 KDC(Key Distribution Center,密钥分发中心)。
Kerberos 系统采用的是时间戳方案来防止重放攻击
计算机病毒
计算机病毒的分类方法有许多种,按照最通用的区分方式,即根据其感染的途径以及采用的技术区分,计算机病毒可分为文件型计算机病毒、引导型计算机病毒、宏病毒和目录型计算机病毒。
- 文件型计算机病毒感染可执行文件(包括 EXE 和 COM 文件)。
- 引导型计算机病毒影响软盘或硬盘的引导扇区。
- 目录型计算机病毒能够修改硬盘上存储的所有文件的地址。
- 宏病毒(Macro)感染的对象是使用某些程序创建的文本文档、数据库、电子表格等文件。
漏洞扫描
| 类型 | 怎么扫描 | 能看到什么 | 主要特点 |
|---|---|---|---|
| 基于网络的扫描 | 扫描器通过网络访问目标主机 | 开放端口、服务版本、网络协议、远程漏洞等 | 部署方便,不必每台机器安装程序 |
| 基于主机的扫描 | 在目标主机安装 Agent/服务,在本机检查 | 系统补丁、配置、文件、注册表、软件版本、权限等 | 检查更深入,产生的网络流量较少 |
安全保护等级
| 等级 | 名称 | 核心特征 | 你可以怎么理解 | 场景 |
|---|---|---|---|---|
| 1 级 | 用户自主保护级 | 自主访问控制 DAC | 用户可以决定“我的资源给谁访问” | |
| 2 级 | 系统审计保护级 | 1 级 + 身份鉴别、审计 | 不但控制访问,还要记录“谁干了什么” | 审计跟踪 |
| 3 级 | 安全标记保护级 | 2 级 + 安全标记、强制访问控制 MAC | 文件和用户都有密级,系统强制判断能不能访问 | |
| 4 级 | 结构化保护级 | 3 级 + 安全机制结构化、强化隔离 | 不仅规则严格,系统本身的安全结构也要设计得严密 | |
| 5 级 | 访问验证保护级 | 对访问进行严格验证,安全机制可信度最高 | 任何访问都要经过可信安全机制检查 | 国家安全、社会稳定的核心领域 |
新技术
数字孪生生态系统:
- 共性应用层涵盖描述、诊断、预测和决策四个方面,需要软件定义的工具和平台支持,以实现这些功能
- 数据互动层主要处理数据采集、传输和处理
- 仿真分析层提供数据建模、仿真和控制服务
- 基础支撑层涉及物联网终端设备和数据采集
建模、仿真和基于数据融合的数字线程是数字孪生体的三项核心技术。
AI 芯片的特点包括 :新型计算范式、训练和推断、大数据处理能力、数据精度高、可重构能力以及专用软件工具。
云原生架构原则包括:服务化原则、弹性原则、可观测原则、韧性原则、所有过程自动化原则、零信任原则和架构持续演进原则。
云计算的架构层次分为 3 个层次:
- 基础设施即服务(IaaS):自己架炉子买肉烤着吃
- 平台即服务(PaaS):去饭店吃自助烤肉
- 软件即服务 (SaaS):去饭店直接吃烤肉
信息物理系统(CPS)通过集成先进的感知、计算、通信、控制等信息技术和自动控制技术,构建了物理空间与信息空间中人、机、物、环境、信息等要素相互映射、适时交互、高效协同的复杂系统,实现系统内资源配置和运行的按需响应、快速迭代、动态优化。
机器人 4.0 的核心技术包括云—边—端的无缝协同计算、持续学习与协同学习、知识图谱、场景自适应和数据安全。
边缘计算
- 边缘计算与云计算的协同包括资源协同、数据协同、智能协同、应用管理协同、业务管理协同和服务协同。
- 边缘计算的特点包括联接性、数据第一入口、约束性和分布性。
- 边缘计算的业务本质是云计算在数据中心之外汇聚节点的延伸和演进,主要包括云边缘、边缘云和云化网关三类落地形态。
其他
- 数据挖掘主要任务:关联分析、聚类分析、分类分析、异常分析、特异群组分析和演变分析等等。
- 结构化分析方法:使用 E-R 图表示数据模型,用 DFD 表示功能模型,用状态转换图表示行为模型。
7 种内聚性由高到低:
- 功能内聚:模块内所有元素完成一个单一功能,各个部分协同工作,缺一不可。
- 顺序内聚:处理元素相关,而且必须顺序执行。
- 通信内聚:模块内所有处理元素都在同一个数据结构上操作,或者各处理使用相同的输入数据或产生相同的输出数据。
- 过程内聚:一个模块完成多个任务,而且这些任务必须按特定的次序执行。
- 瞬时内聚 (时间内聚):所包含的任务必须在同一时间间隔内执行。
- 逻辑内聚:模块内执行若干个逻辑上相似的功能,通过参数确定该模块完成哪一个功能。
- 偶然内聚 (巧合内聚):完成一组没有关系或松散关系的任务。
数据管理能力成熟度评估模型 (DCMM) 将组织数据管理能力划分为 8 个能力域,分别为:数据战略、数据治理、数据架构、数据应用、数据安全、数据质量、数据标准和数据生存周期
软件结构化设计包括架构设计、接口设计、数据设计和过程设计等任务。
SoC 是一款具有运算能力的处理器芯片,可面向特定用途进行定制的标准产品
AI 芯片架构
AI 芯片主要有三种技术架构:GPU、FPGA、ASIC。
第一种是 GPU,可以高效支持 AI 应用的通用芯片,但是相对于 FPGA 和 ASIC 来说,价格和功耗过高; 第二种是 FPGA(现场可编程门阵列),可对芯片硬件层进行编程和配置,实现半定制化,相对于 GPU 有更低的功耗; 第三种是 ASIC(专用集成电路),专门为特定的 AI 产品或者服务而设计,主要是侧重加速机器学习(尤其是神经网络、深度学习),它针对特定的计算网络结构采用了硬件电路实现的方式,能够在很低的功耗下实现非常高的能效比,这也是目前 AI 芯片中最多的形式。
数学
- 在线性规划中,如果 X 和 Y 都是某线性规划问题的最优解,那么任何在 X 和 Y 之间的凸组合也是其最优解,即 ,其中 并且 。
- 0 到 1000 的数字里,只有一个 5 的数字有( 243 )个。 把 0~999 都看成三位数,不足三位的前面补 0。这个 5 可以出现在百位、十位、个位:3 种位置;剩下两个位置都不能是 5,每个位置有 9 种选择;
成本计算
某厂生产某种电视机,销售价为每台 2500 元,去年的总销售量为 25000 台,固定成本总额为 250 万元,可变成本总额为 4000 万元,税率为 16%,则该产品年销售量的盈亏平衡点为( )台。(只有在年销售量超过它时才能有盈利)。
营业额:2.5 万台 x 2500 元/台 = 6250 万元 可变成本占总营收比例:4000 / 6250 = 0.64
设盈亏平衡(利润为 0)时销售 台,则:
解得 台
马尔可夫链稳定状态
转移矩阵是:
设最终稳定时,A、B 两个品牌的市场占有率分别为:,因为最终稳定后“下一月和这一月一样”,所以满足:。
同时市场占有率总和一定是 1:,把矩阵乘起来:
得到:
实际上前两个方程只需要用一个,解得 。
工期规划
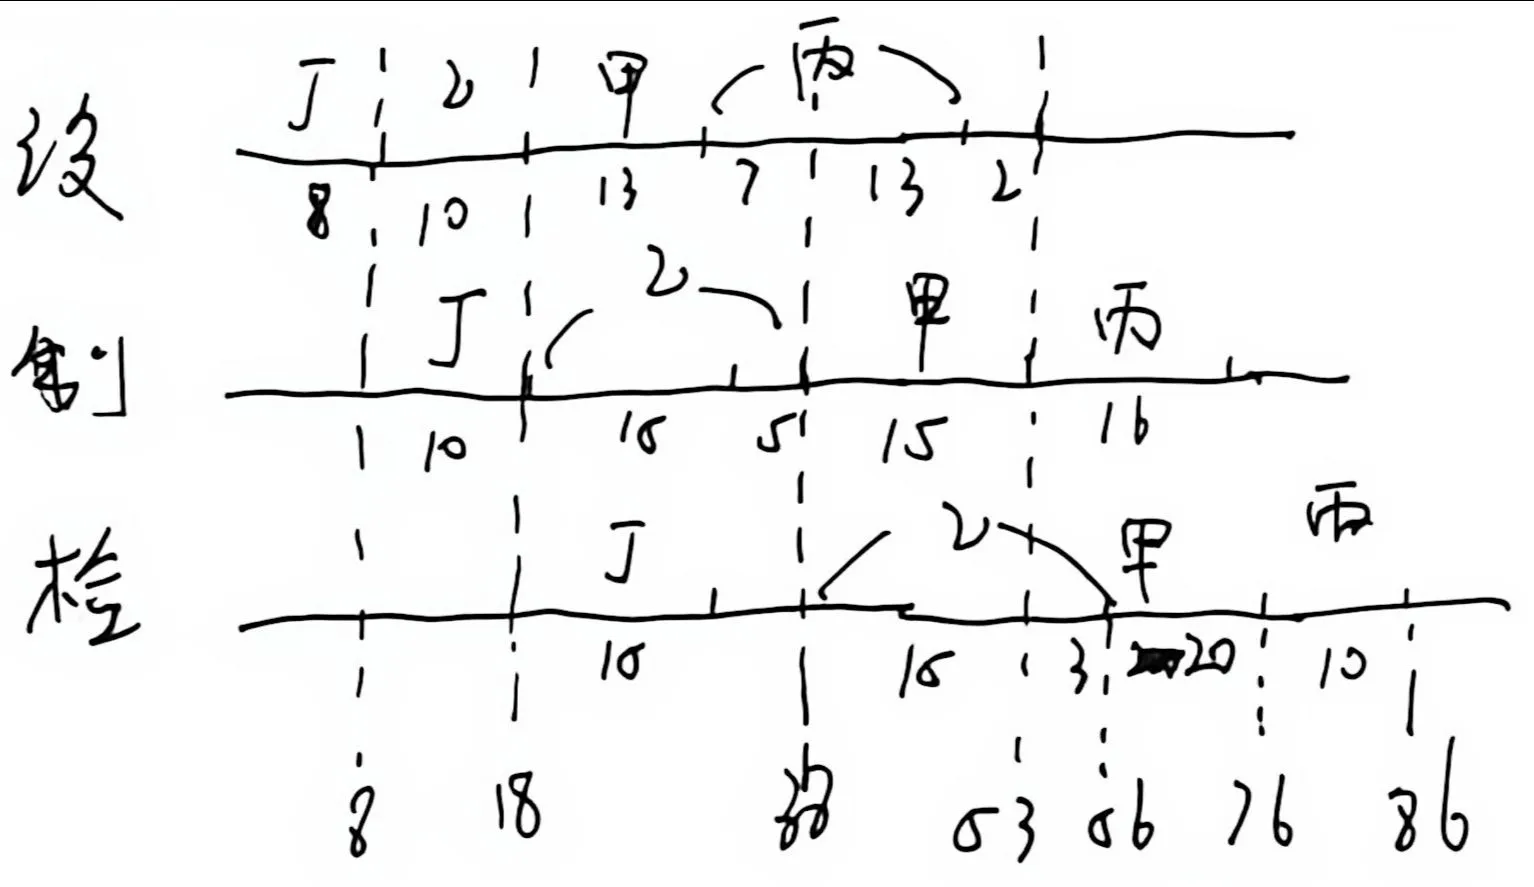
某企业拟生产甲、乙、丙、丁四个产品。每个产品必须依次由设计部门、制造部门和检验部门进行设计、制造和检验,每个部门生产产品的顺序是相同的。各产品各工序所需的时间如下表所示:
| 项目 | 设计(天) | 制造(天) | 检验(天) |
|---|---|---|---|
| 甲 | 13 | 15 | 20 |
| 乙 | 10 | 20 | 18 |
| 丙 | 20 | 16 | 10 |
| 丁 | 8 | 10 | 15 |
只要适当安排好项目实施顺序,企业最快可以在( )天全部完成这四个项目。
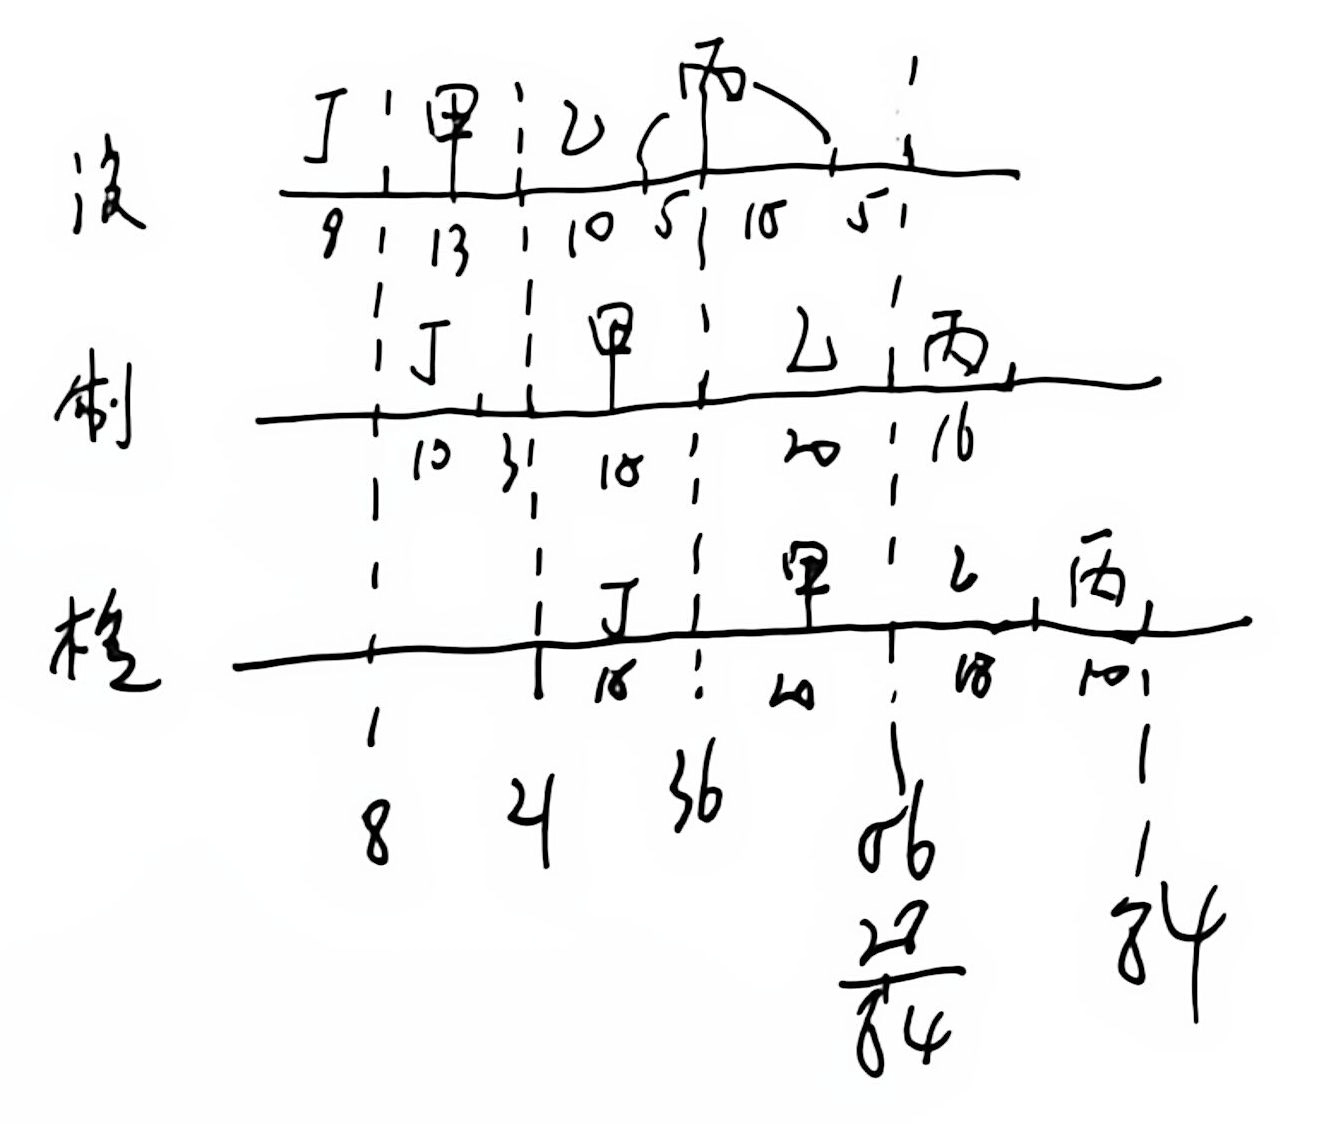
生产决策
生产某种产品有两个建厂方案:(1)建大厂,需要初期投资 500 万元。如果产品销路好,每年可以获利 200 万元;如果销路不好,每年会亏损 20 万元。(2)建小厂,需要初期投资 200 万元。如果产品销路好,每年可以获利 100 万元;如果销路不好,每年只能获利 20 万元。
市扬调研表明,未来 2 年这种产品销路好的概率为 70%。如果这 2 年销路好,则后续 5 年销路好的概率上升为 80%;如果这 2 年销路不好,则后续 5 年销路好的概率仅为 10%。为取得 7 年最大总收益,决策者应( )。
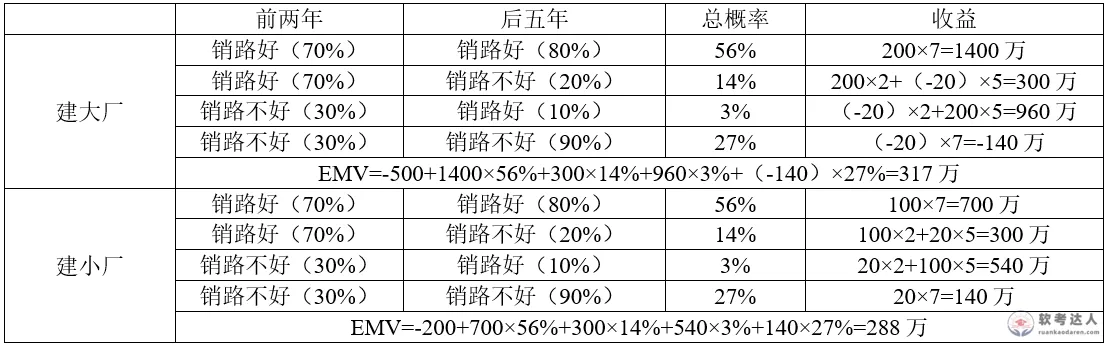
建大厂,总收益略多于 300 万元。


分享文章
生成精美分享图或复制链接,与更多人分享本文。
继续阅读
换条路线
从其他文章中稳定抽取
最后更新于 ,距今已过 0 天
部分内容可能已过时